Trà Đá Data — trang chủ

Giỏ hàng

Giỏ hàng rỗng

Hãy khám phá các khóa học của chúng tôi!

Xem khóa học
← Quay lại Blog

hàm thống kê

19 bài viết được gắn tag này

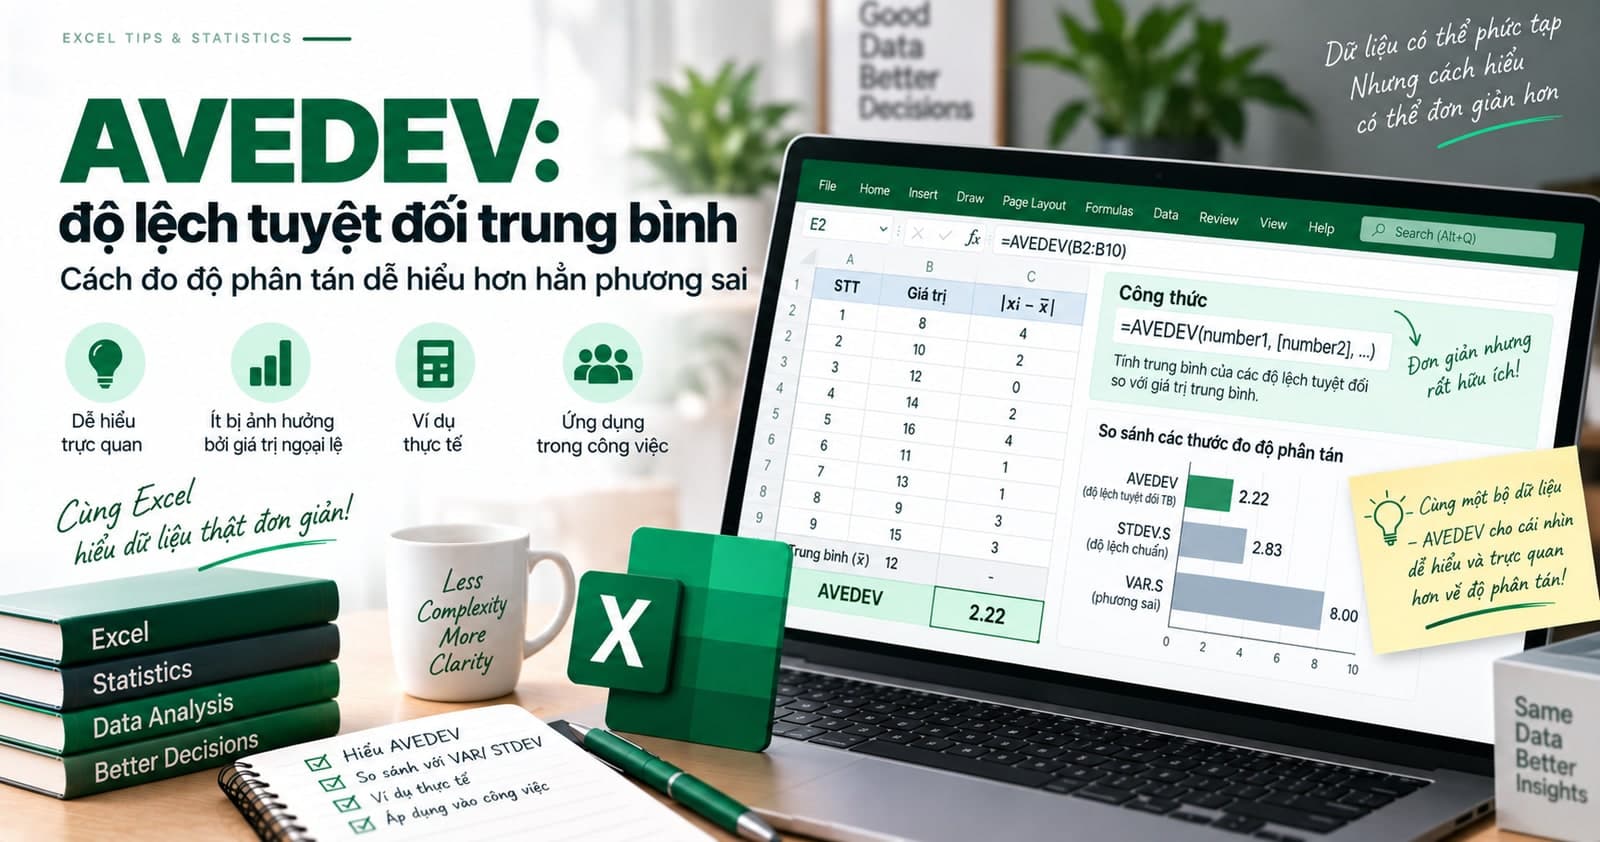
AVEDEV: độ lệch tuyệt đối trung bình, cách đo độ phân tán dễ hiểu hơn hẳn phương sai
📗 Excel

AVEDEV: độ lệch tuyệt đối trung bình, cách đo độ phân tán dễ hiểu hơn hẳn phương sai

AVEDEV đo độ phân tán bằng trung bình của các khoảng cách tuyệt đối tới trung bình — cùng đơn vị với dữ liệu gốc, dễ diễn giải hơn hẳn độ lệch chuẩn vốn phải đi qua bước bình phương rồi khai căn.

14 tháng 9, 20263 phút đọc
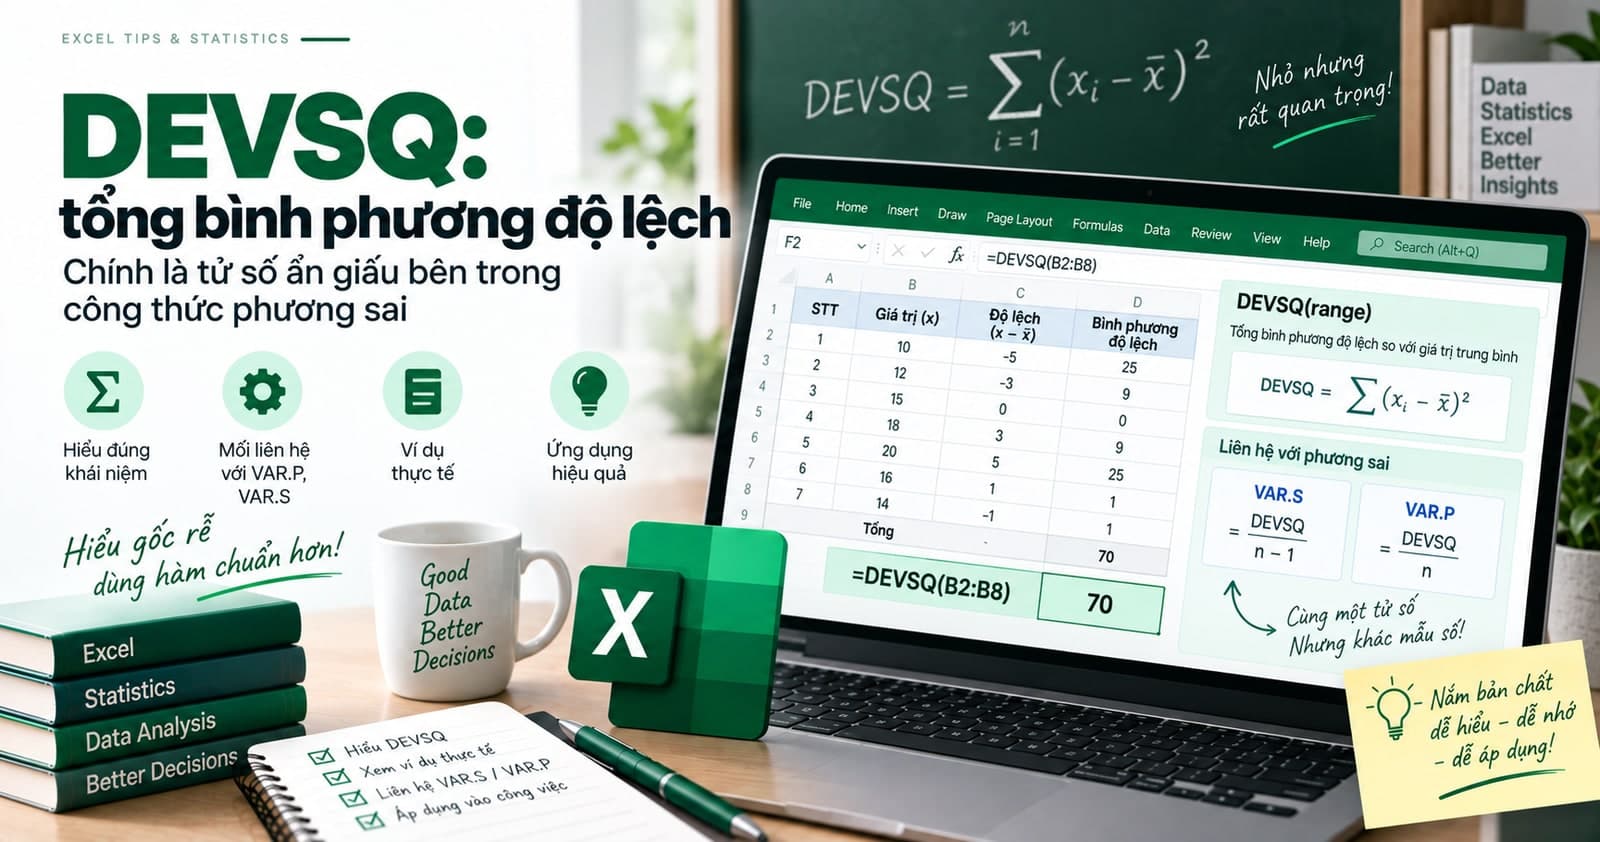
DEVSQ: tổng bình phương độ lệch, chính là tử số ẩn giấu bên trong công thức phương sai
📗 Excel

DEVSQ: tổng bình phương độ lệch, chính là tử số ẩn giấu bên trong công thức phương sai

DEVSQ tính tổng bình phương độ lệch so với trung bình — chính là phần tử số trong công thức VAR.P và VAR.S, trước khi chia cho n hoặc n-1. Hữu ích khi cần so sánh trực tiếp mức phân tán tuyệt đối giữa các nhóm cùng cỡ mẫu.

14 tháng 9, 20263 phút đọc
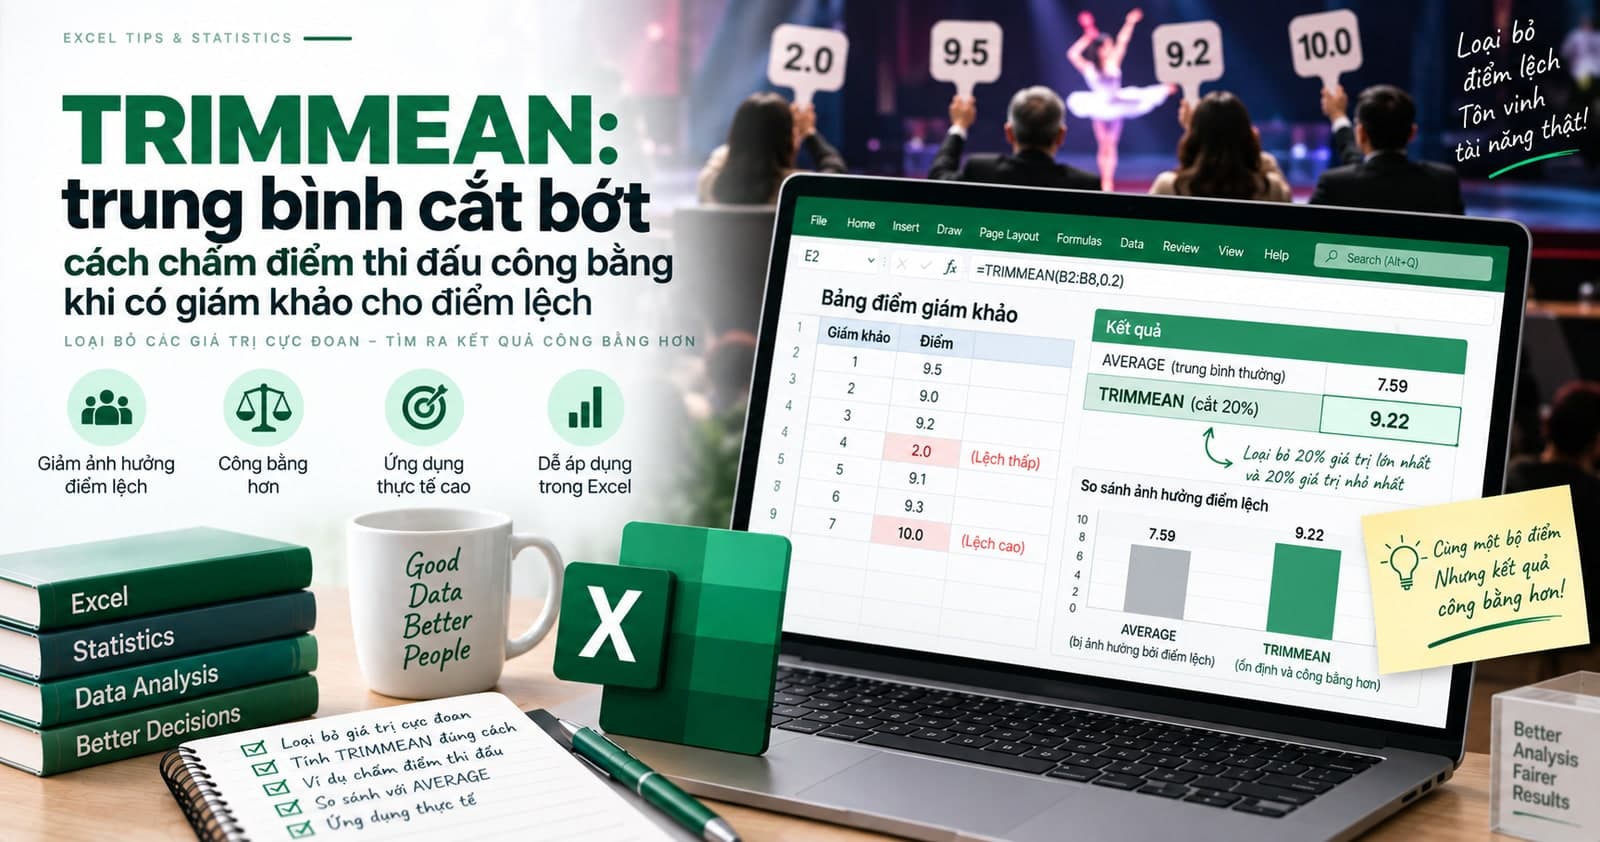
TRIMMEAN: trung bình cắt bớt, cách chấm điểm thi đấu công bằng khi có giám khảo cho điểm lệch
📗 Excel

TRIMMEAN: trung bình cắt bớt, cách chấm điểm thi đấu công bằng khi có giám khảo cho điểm lệch

TRIMMEAN loại bỏ một tỷ lệ dữ liệu ở cả hai đầu (cao nhất và thấp nhất) trước khi tính trung bình — đúng cách nhiều cuộc thi thể thao, nghệ thuật chấm điểm để một giám khảo cho điểm quá lệch không làm sai kết quả chung.

14 tháng 9, 20263 phút đọc
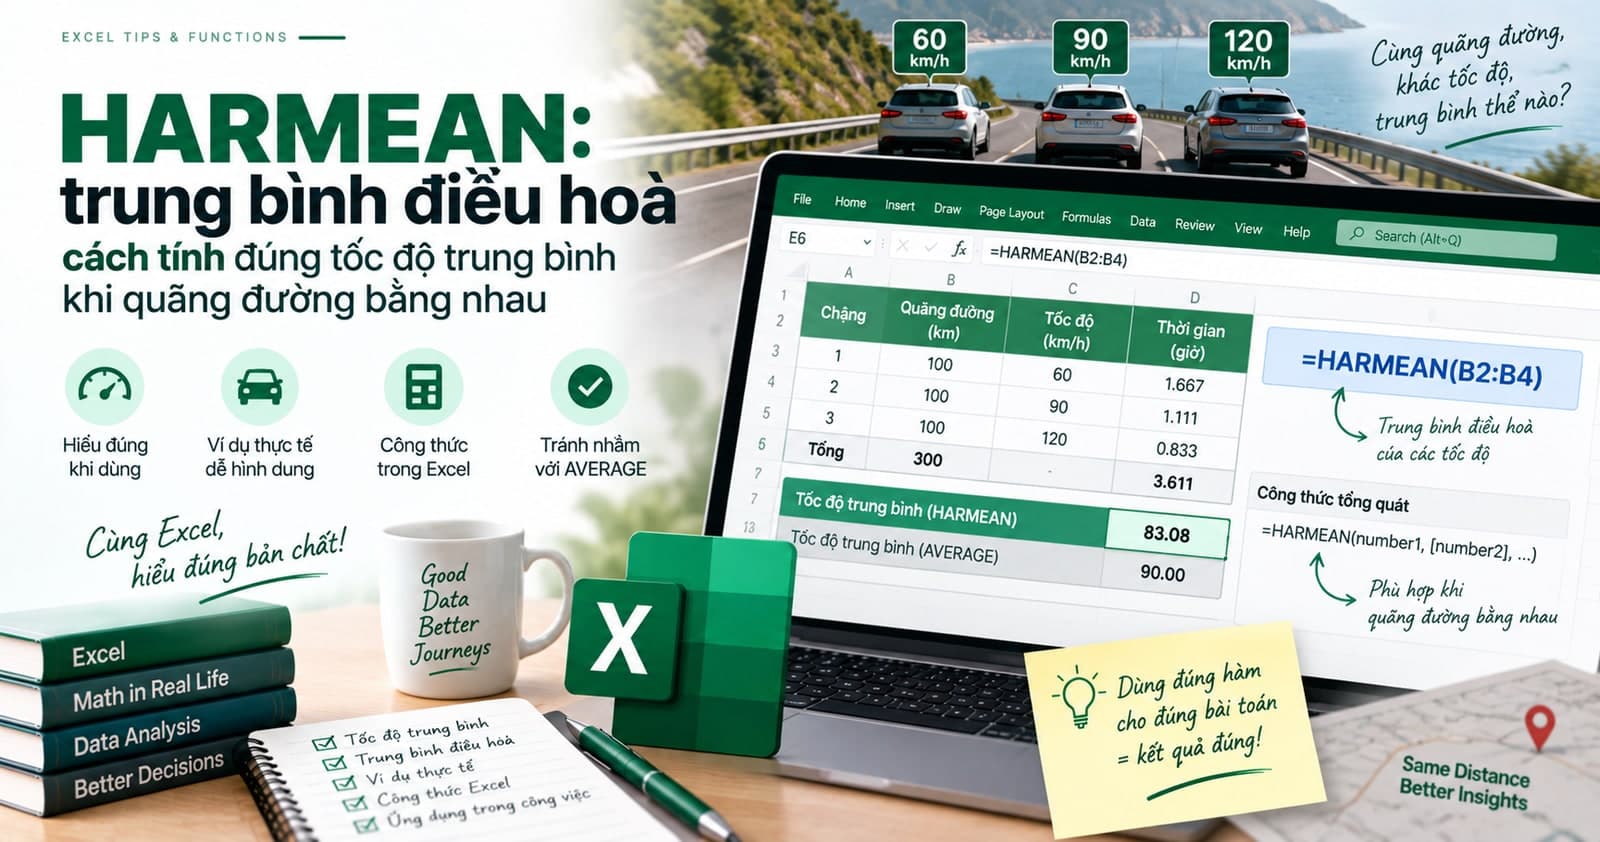
HARMEAN: trung bình điều hoà, cách tính đúng tốc độ trung bình khi quãng đường bằng nhau
📗 Excel

HARMEAN: trung bình điều hoà, cách tính đúng tốc độ trung bình khi quãng đường bằng nhau

HARMEAN tính trung bình điều hoà — nghịch đảo của trung bình cộng các nghịch đảo — cho kết quả đúng khi cần tính tốc độ trung bình của một hành trình đi cùng một quãng đường ở nhiều tốc độ khác nhau. Chỉ nhận số dương.

14 tháng 9, 20263 phút đọc
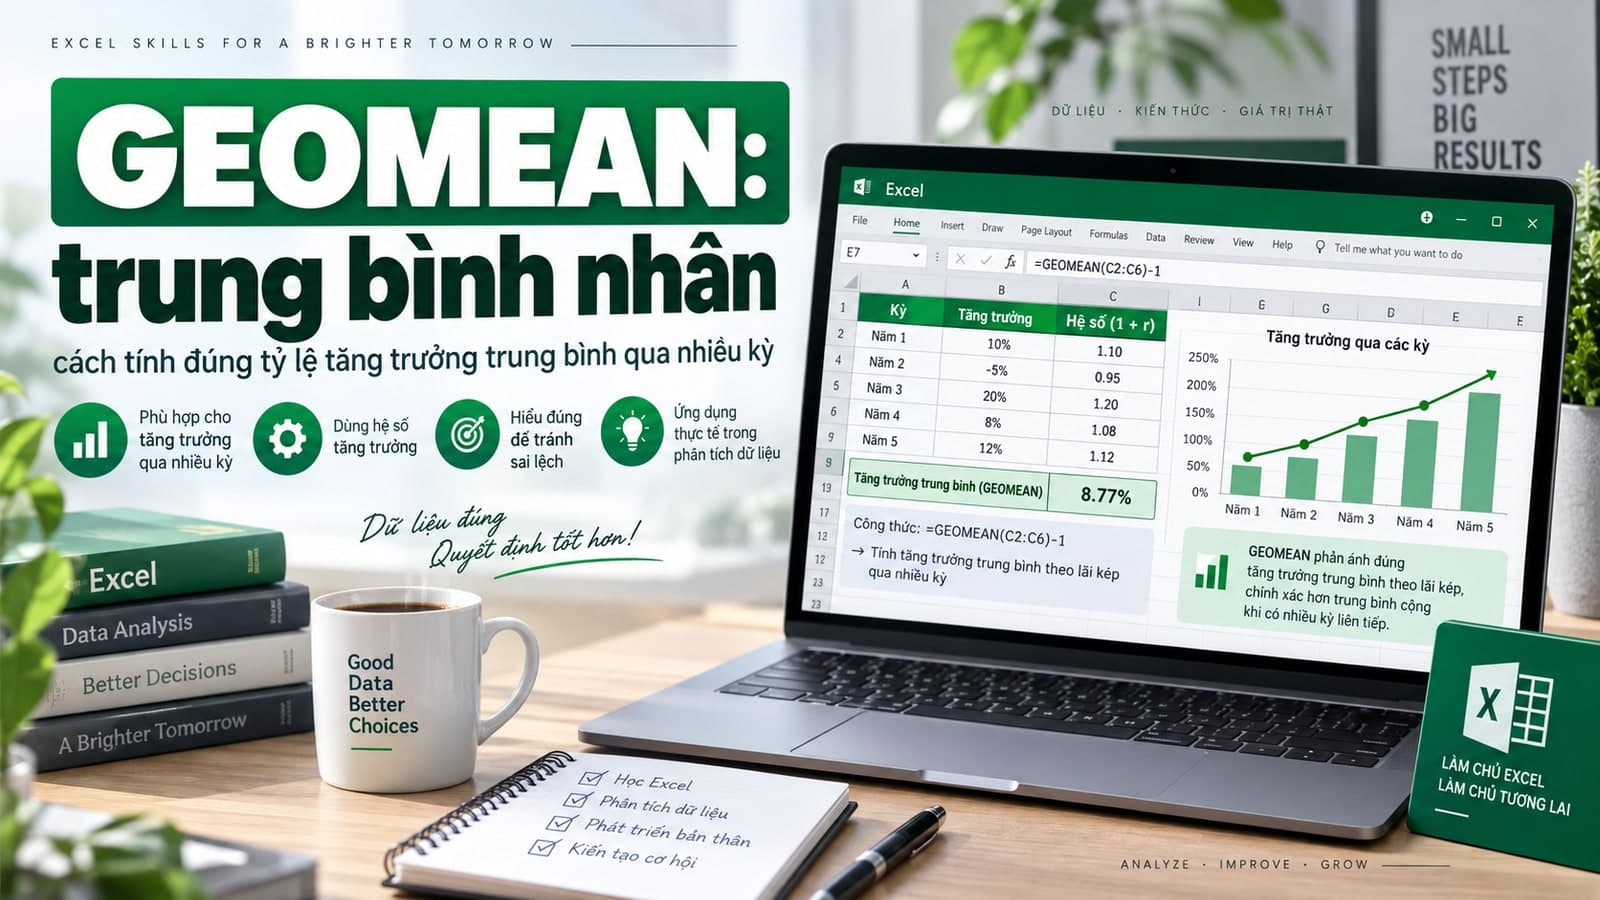
GEOMEAN: trung bình nhân, cách tính đúng tỷ lệ tăng trưởng trung bình qua nhiều kỳ
📗 Excel

GEOMEAN: trung bình nhân, cách tính đúng tỷ lệ tăng trưởng trung bình qua nhiều kỳ

GEOMEAN tính trung bình nhân — căn bậc n của tích n số — cho kết quả khác hẳn AVERAGE khi cần tính tỷ lệ tăng trưởng trung bình qua nhiều kỳ. Chỉ nhận số dương, số 0 hoặc âm đều báo lỗi.

14 tháng 9, 20263 phút đọc
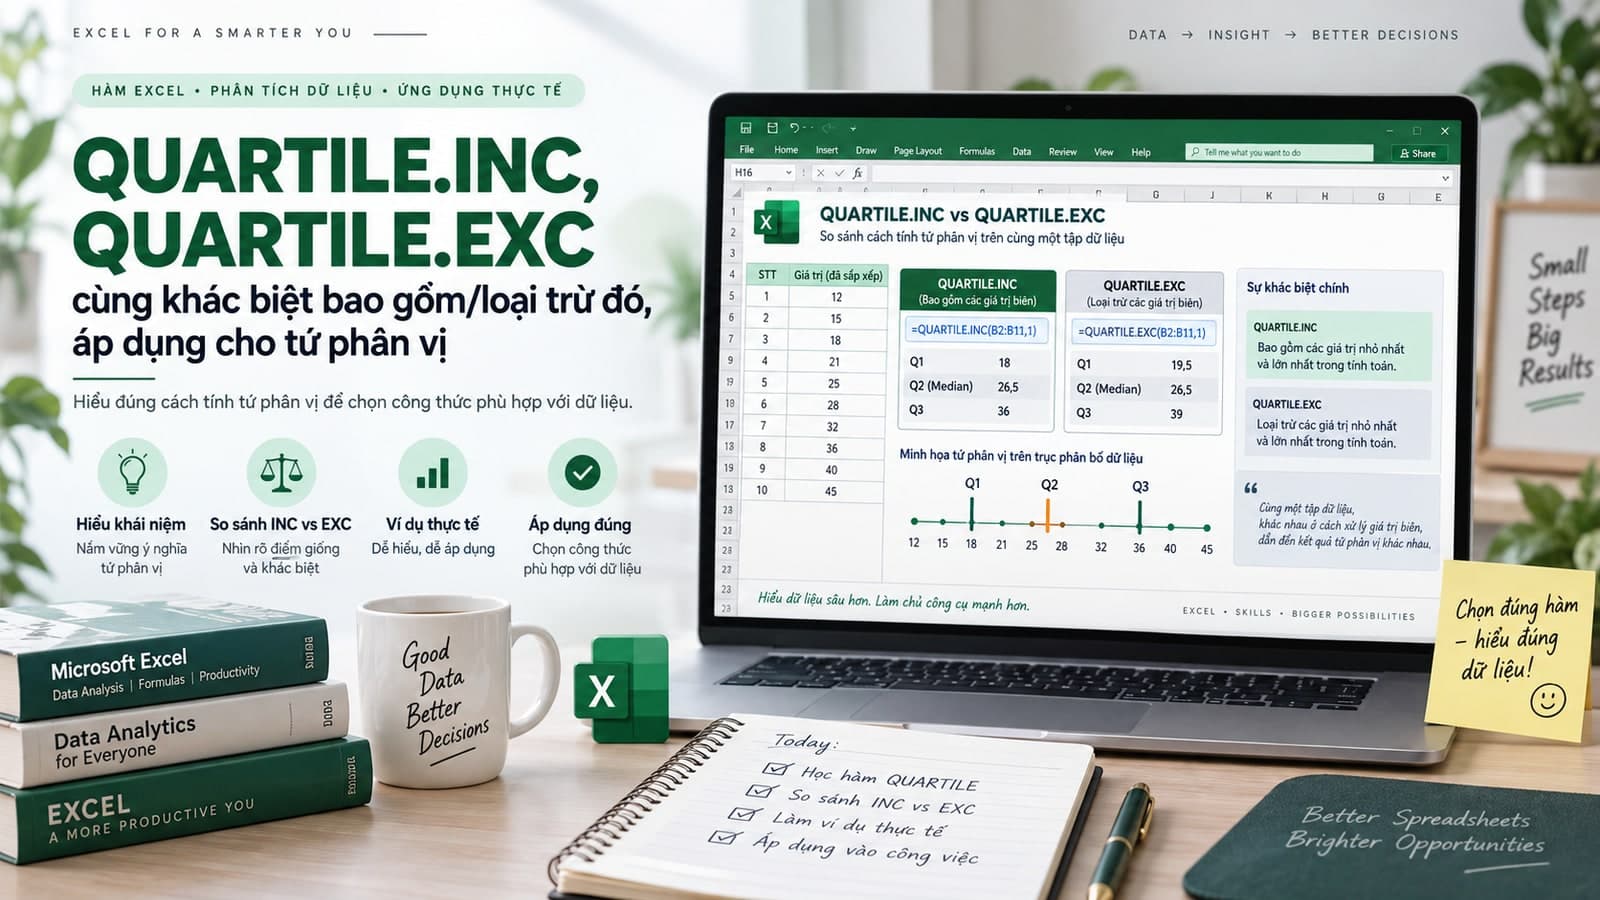
QUARTILE.INC, QUARTILE.EXC: cùng khác biệt bao gồm/loại trừ đó, áp dụng cho tứ phân vị
📗 Excel

QUARTILE.INC, QUARTILE.EXC: cùng khác biệt bao gồm/loại trừ đó, áp dụng cho tứ phân vị

QUARTILE.INC và QUARTILE.EXC chia dữ liệu thành bốn phần bằng nhau, cùng khác biệt bao gồm/loại trừ đầu mút như PERCENTILE.INC/EXC — nhưng QUARTILE.EXC còn không chấp nhận tham số quart bằng 0 hoặc 4, vì hai giá trị đó tương ứng đúng giá trị nhỏ nhất và lớn nhất bị loại trừ.

14 tháng 9, 20263 phút đọc
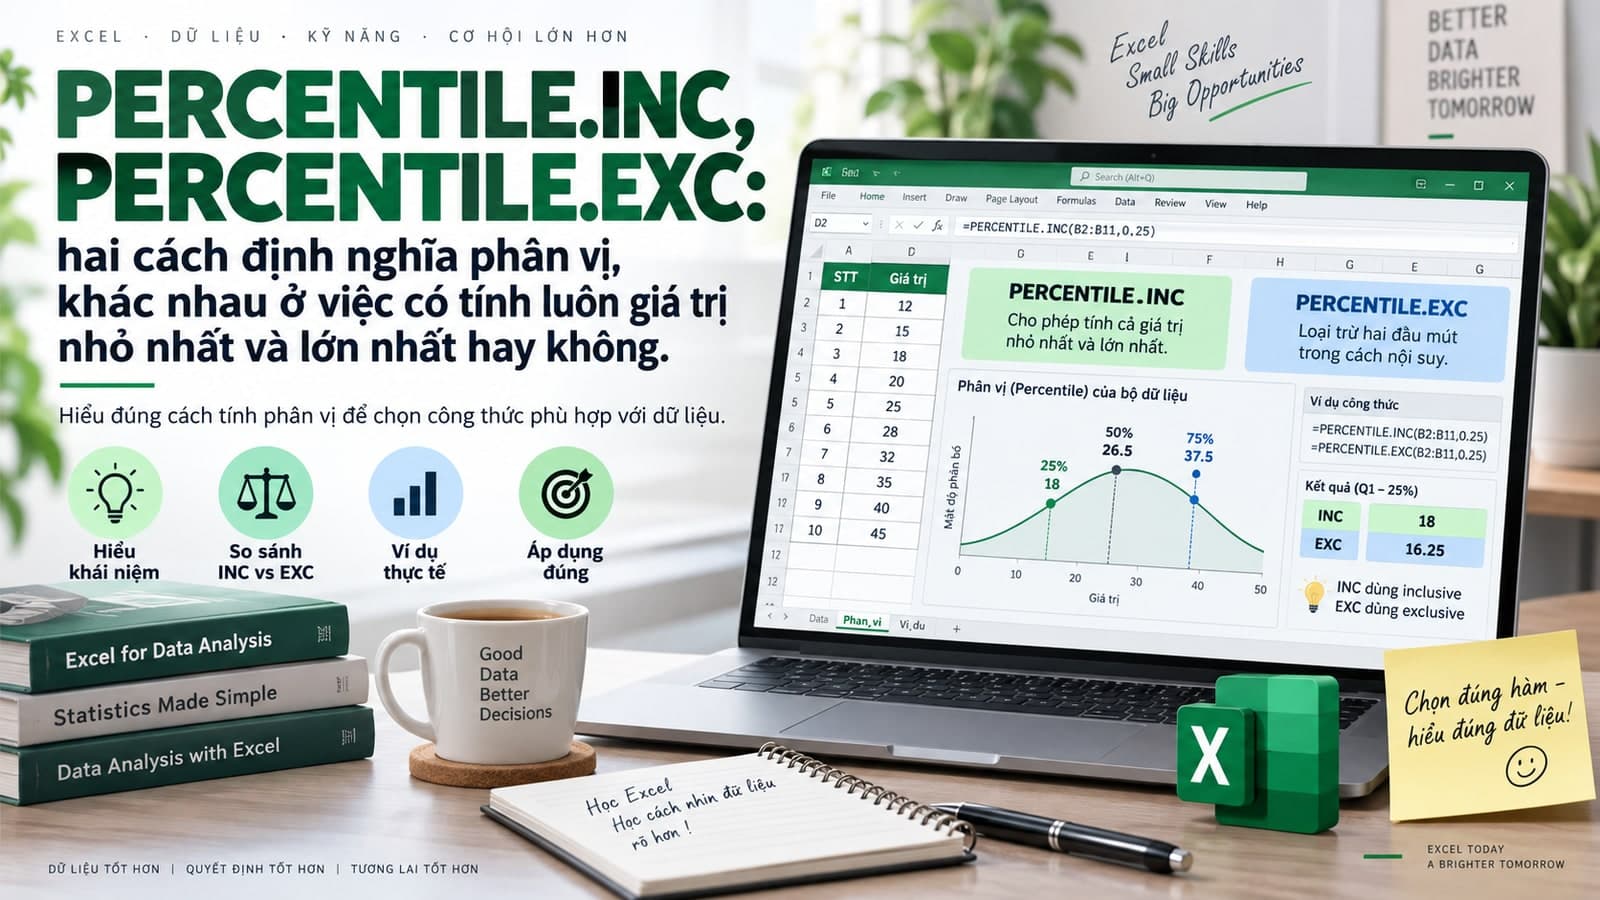
PERCENTILE.INC, PERCENTILE.EXC: hai cách định nghĩa phân vị, khác nhau ở việc có tính luôn giá trị nhỏ nhất và lớn nhất hay không
📗 Excel

PERCENTILE.INC, PERCENTILE.EXC: hai cách định nghĩa phân vị, khác nhau ở việc có tính luôn giá trị nhỏ nhất và lớn nhất hay không

PERCENTILE.INC (bao gồm) cho phép tính phân vị 0 và 100 tức chính giá trị nhỏ nhất/lớn nhất, còn PERCENTILE.EXC (loại trừ) không cho phép và giới hạn phạm vi hợp lệ hẹp hơn, báo lỗi nếu vượt ra ngoài.

14 tháng 9, 20263 phút đọc
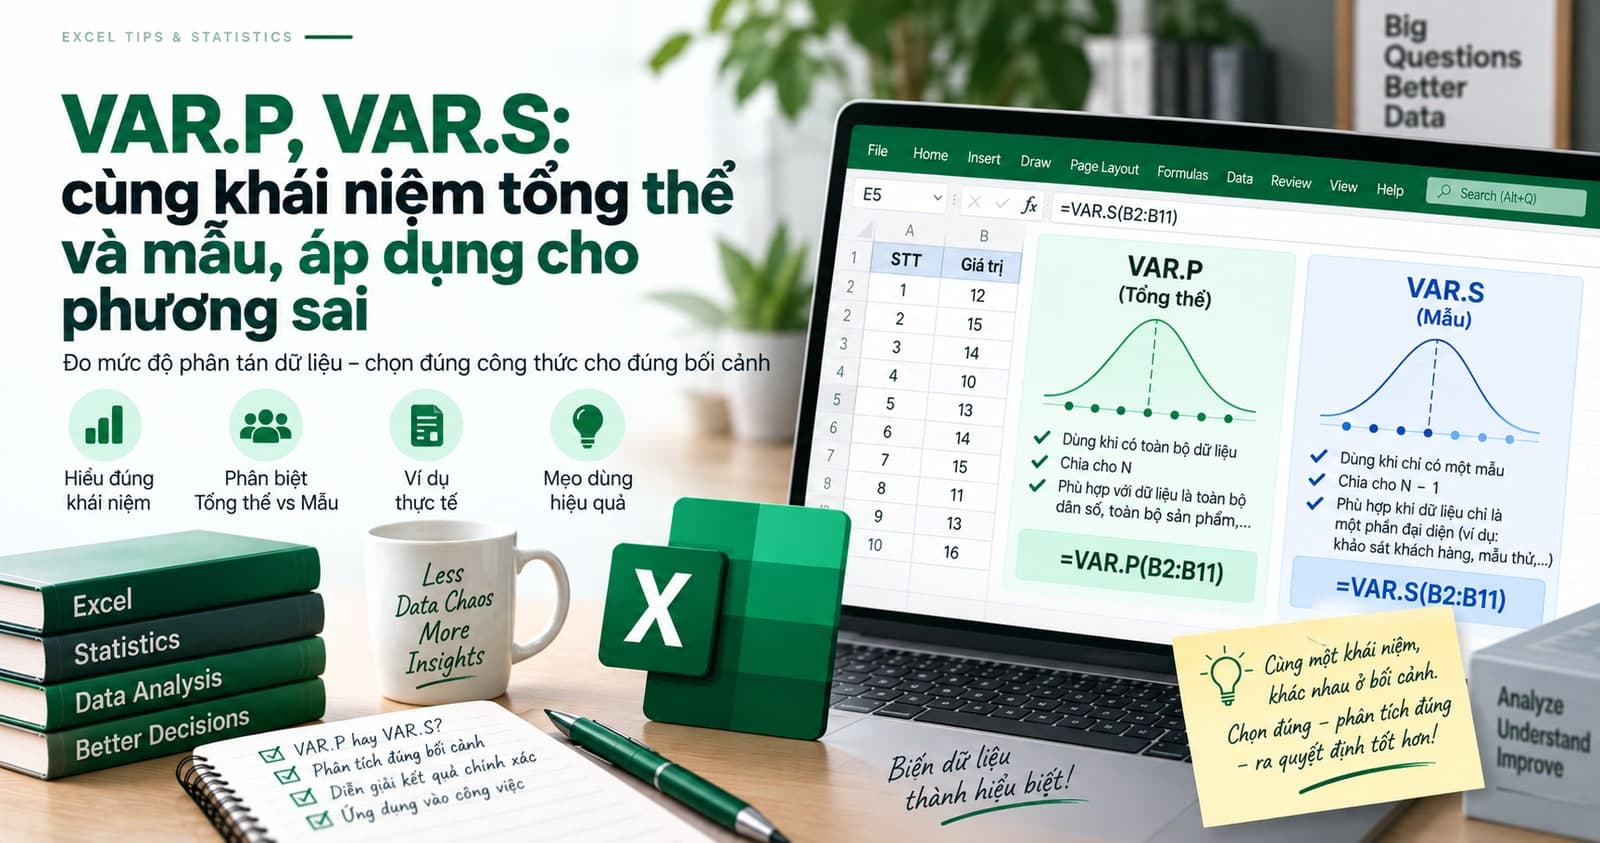
VAR.P, VAR.S: cùng khái niệm tổng thể và mẫu, áp dụng cho phương sai
📗 Excel

VAR.P, VAR.S: cùng khái niệm tổng thể và mẫu, áp dụng cho phương sai

VAR.P và VAR.S tính phương sai theo đúng khái niệm tổng thể và mẫu như STDEV.P/STDEV.S — thực chất VAR chính là STDEV trước khi khai căn, nên chọn sai loại cũng dẫn tới cùng một sai lệch khái niệm.

14 tháng 9, 20263 phút đọc
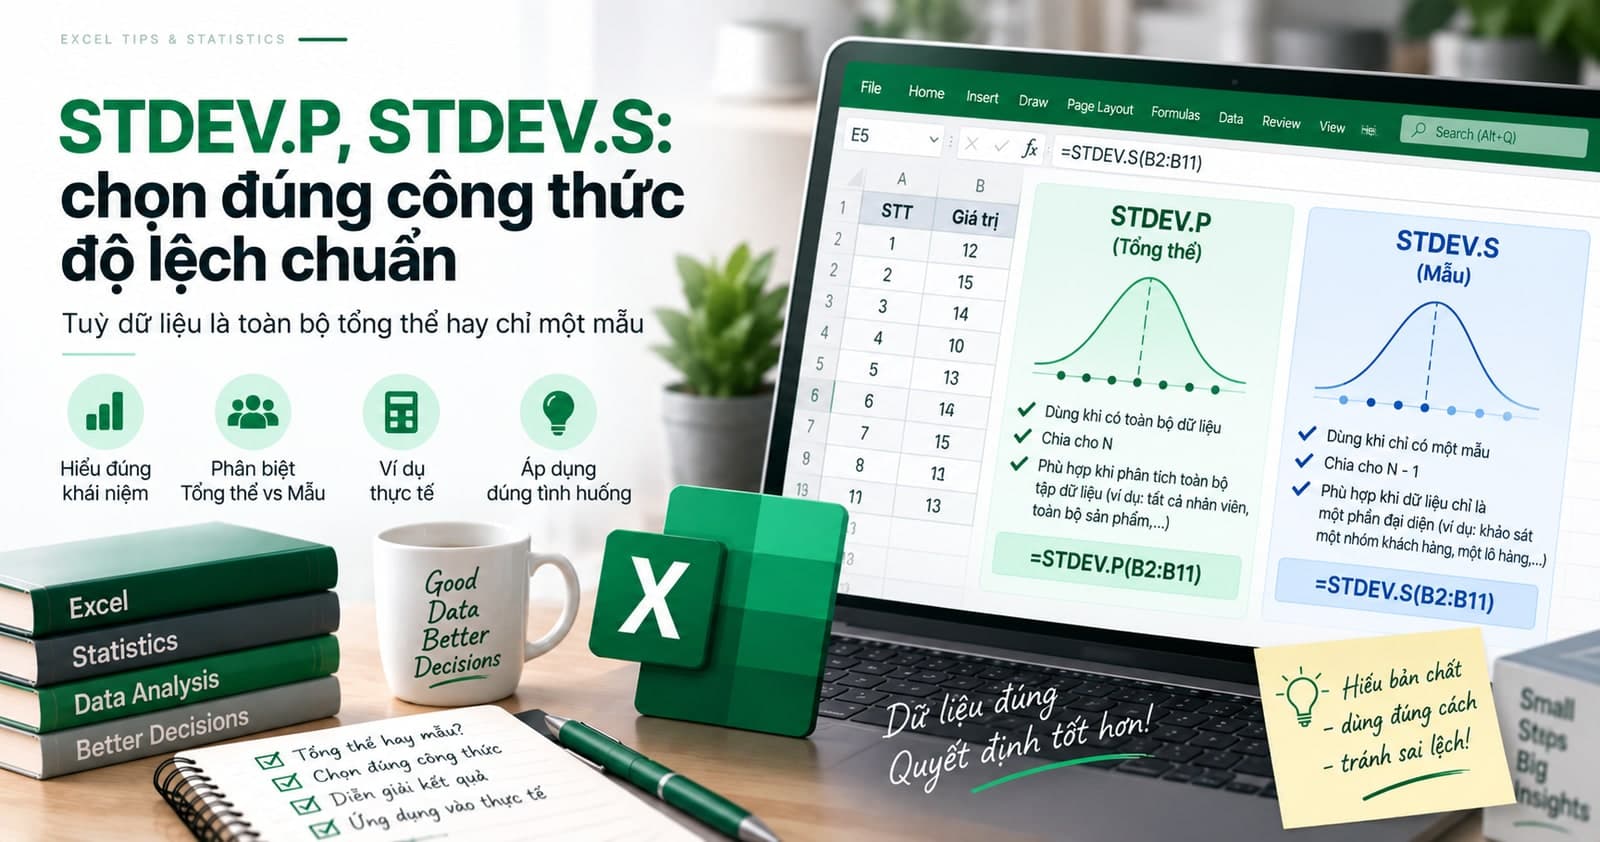
STDEV.P, STDEV.S: chọn đúng công thức độ lệch chuẩn tuỳ dữ liệu là toàn bộ tổng thể hay chỉ một mẫu
📗 Excel

STDEV.P, STDEV.S: chọn đúng công thức độ lệch chuẩn tuỳ dữ liệu là toàn bộ tổng thể hay chỉ một mẫu

STDEV.S tính độ lệch chuẩn khi dữ liệu chỉ là một mẫu rút ra từ tổng thể lớn hơn, STDEV.P tính khi dữ liệu là toàn bộ tổng thể cần khảo sát. Chọn sai loại cho ra kết quả khác nhau, chênh lệch rõ nhất khi cỡ dữ liệu nhỏ.

14 tháng 9, 20263 phút đọc
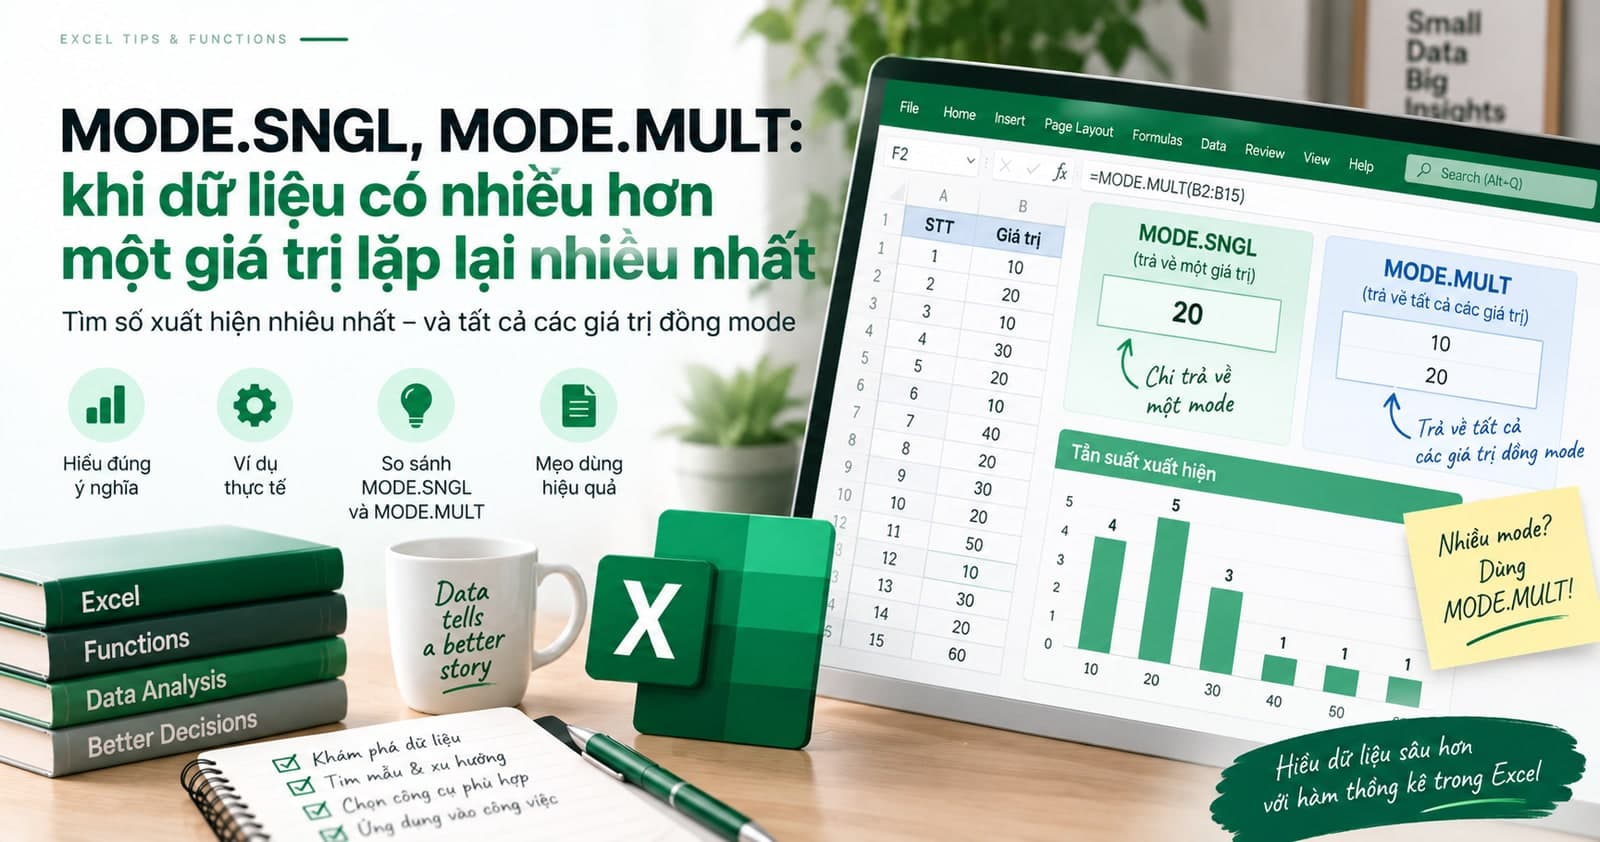
MODE.SNGL, MODE.MULT: khi dữ liệu có nhiều hơn một giá trị lặp lại nhiều nhất
📗 Excel

MODE.SNGL, MODE.MULT: khi dữ liệu có nhiều hơn một giá trị lặp lại nhiều nhất

MODE.SNGL là bản thay thế hiện đại của MODE cũ, vẫn chỉ trả về đúng một giá trị dù dữ liệu có nhiều mode bằng nhau. MODE.MULT giải đúng vấn đề đó — trả về toàn bộ các giá trị đang đồng hạng lặp lại nhiều nhất dưới dạng một mảng.

14 tháng 9, 20263 phút đọc
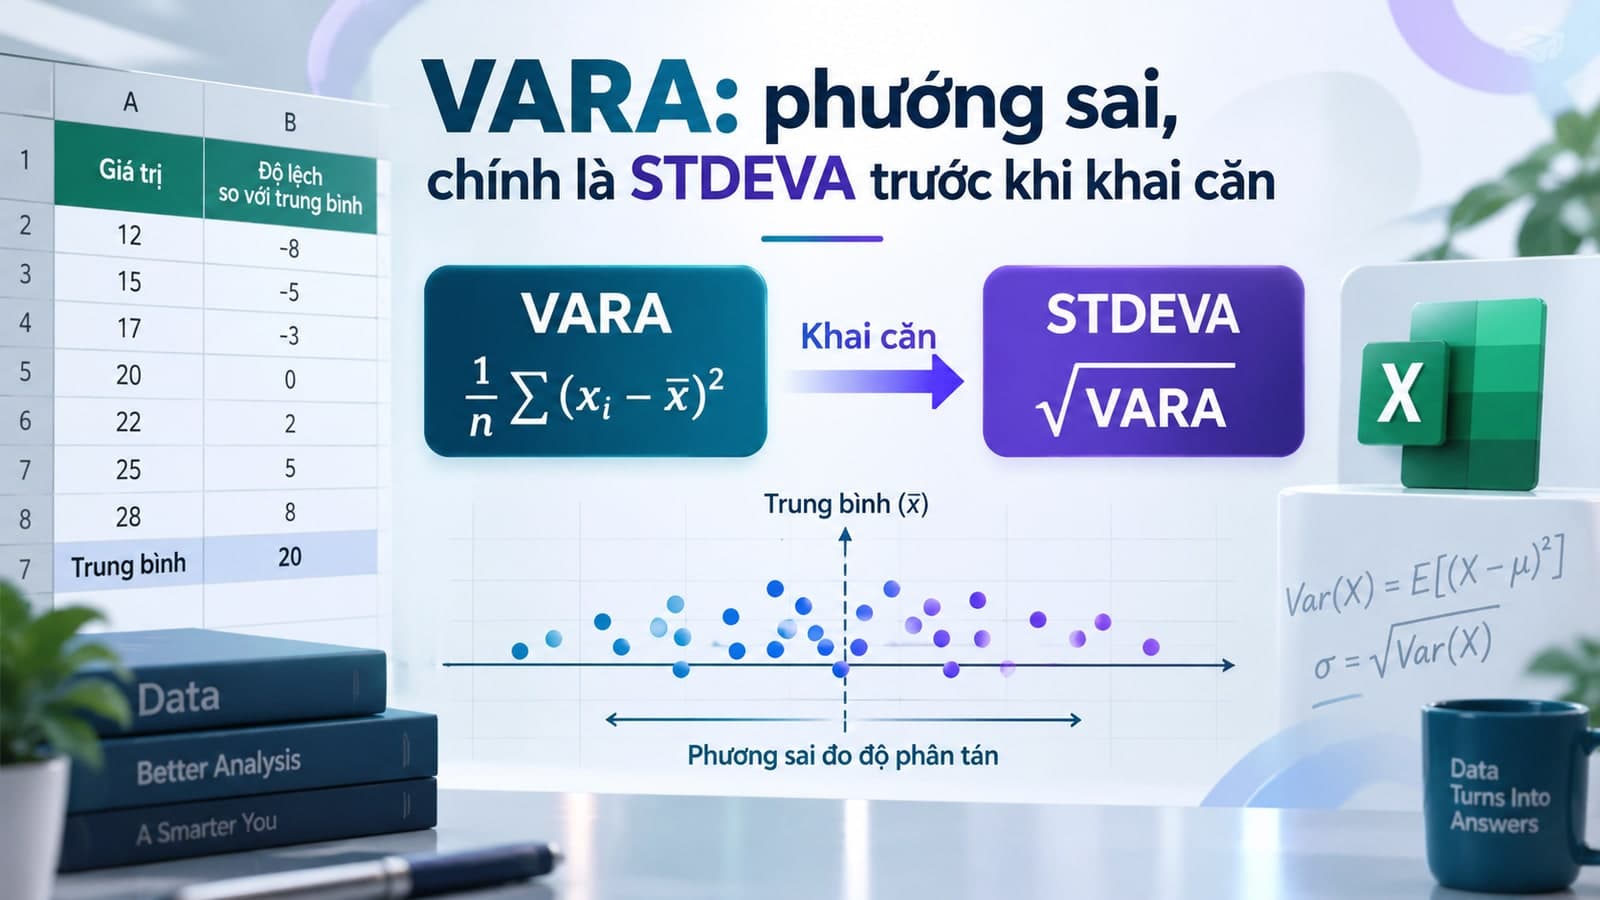
VARA: phương sai, chính là STDEVA trước khi khai căn
📗 Excel

VARA: phương sai, chính là STDEVA trước khi khai căn

VARA tính phương sai theo đúng quy tắc quy đổi văn bản và luận lý như STDEVA — thực chất VARA chính là bình phương của STDEVA, chỉ khác bước khai căn cuối cùng. Cùng cái bẫy thổi phồng kết quả khi dữ liệu lẫn ô văn bản.

14 tháng 9, 20263 phút đọc
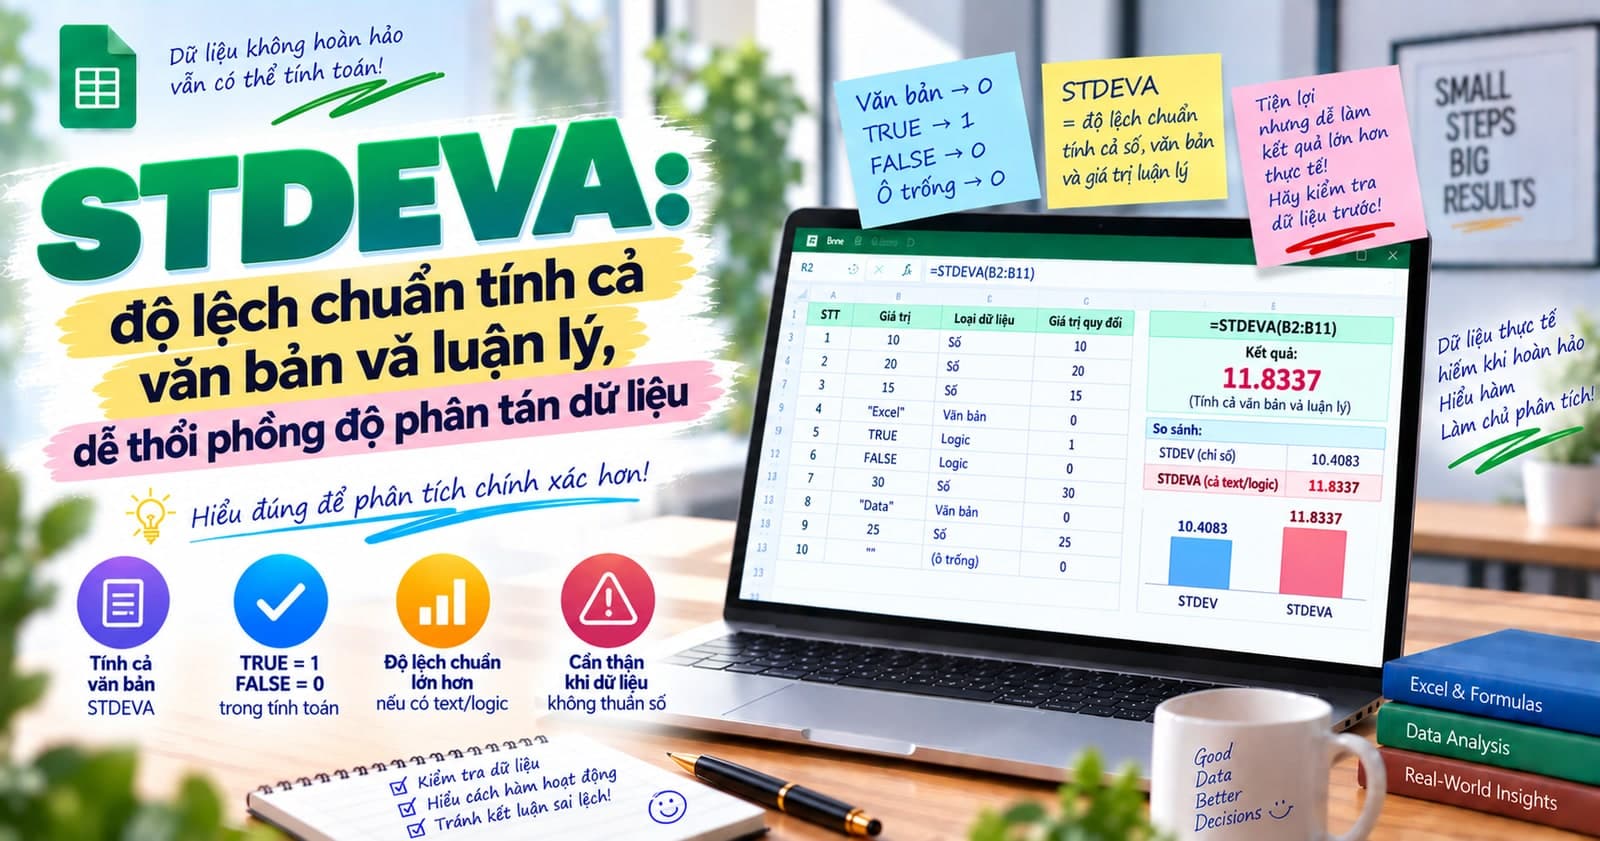
STDEVA: độ lệch chuẩn tính cả văn bản và luận lý, dễ thổi phồng độ phân tán dữ liệu
📗 Excel

STDEVA: độ lệch chuẩn tính cả văn bản và luận lý, dễ thổi phồng độ phân tán dữ liệu

STDEVA tính độ lệch chuẩn như STDEV, nhưng quy đổi văn bản thành 0 và TRUE thành 1 thay vì bỏ qua — một ô ghi chú lẫn vào dữ liệu số có thể thổi phồng độ lệch chuẩn lên gấp nhiều lần, khiến dữ liệu trông phân tán hơn hẳn thực tế.

11 tháng 9, 20263 phút đọc
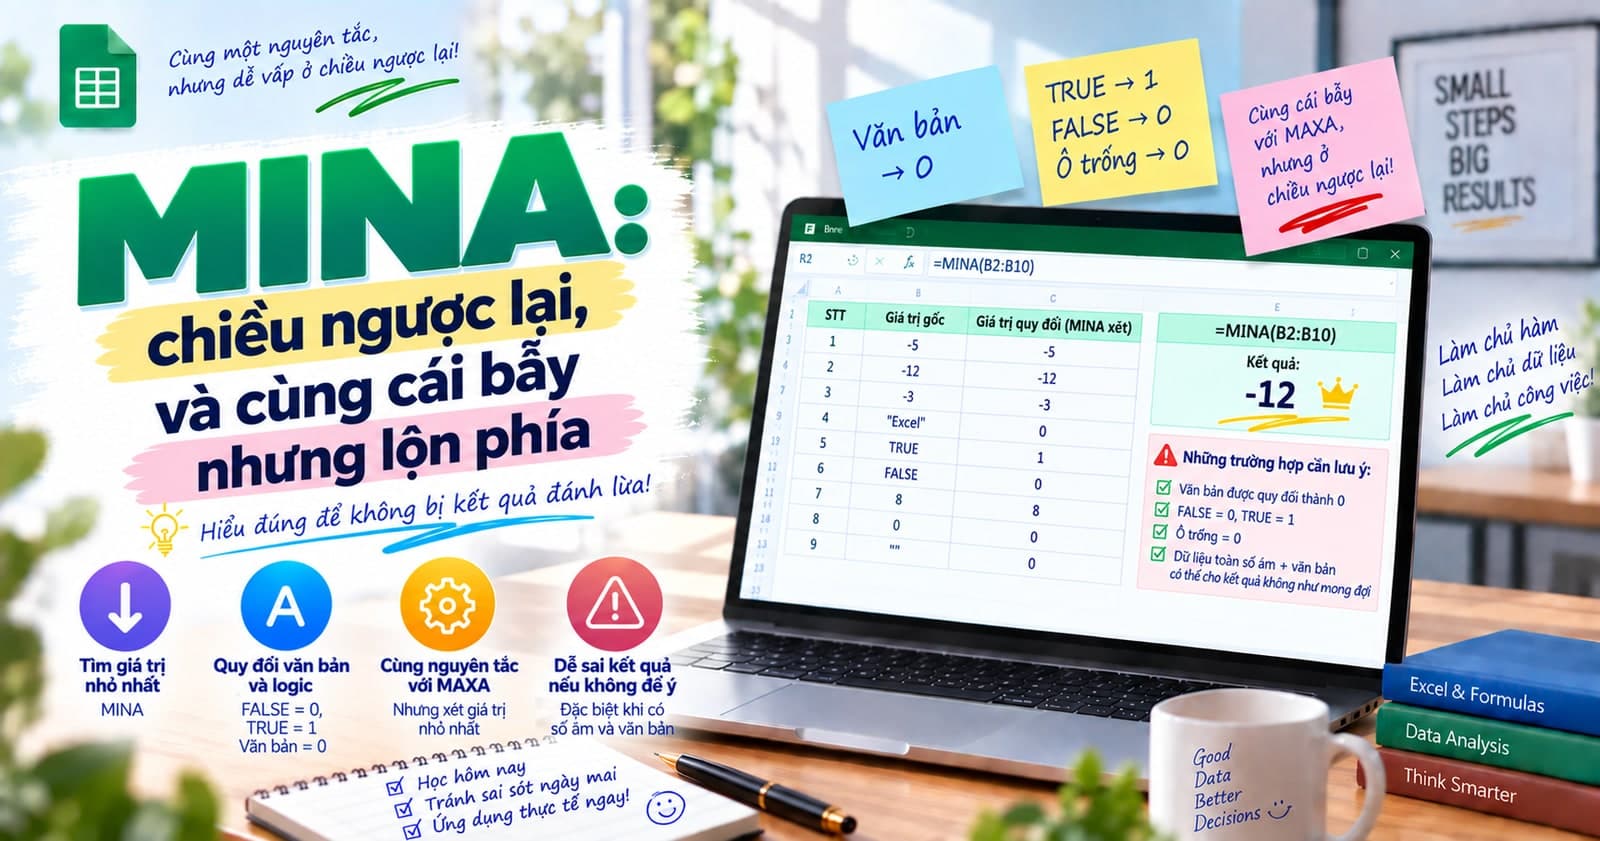
MINA: chiều ngược lại, và cùng cái bẫy nhưng lộn phía
📗 Excel

MINA: chiều ngược lại, và cùng cái bẫy nhưng lộn phía

MINA tìm giá trị nhỏ nhất như MIN, nhưng tính cả FALSE (=0) và văn bản (=0) thay vì bỏ qua. Nguy hiểm nhất khi dữ liệu toàn số dương — một ô FALSE hay văn bản duy nhất có thể kéo kết quả MINA về 0.

11 tháng 9, 20263 phút đọc
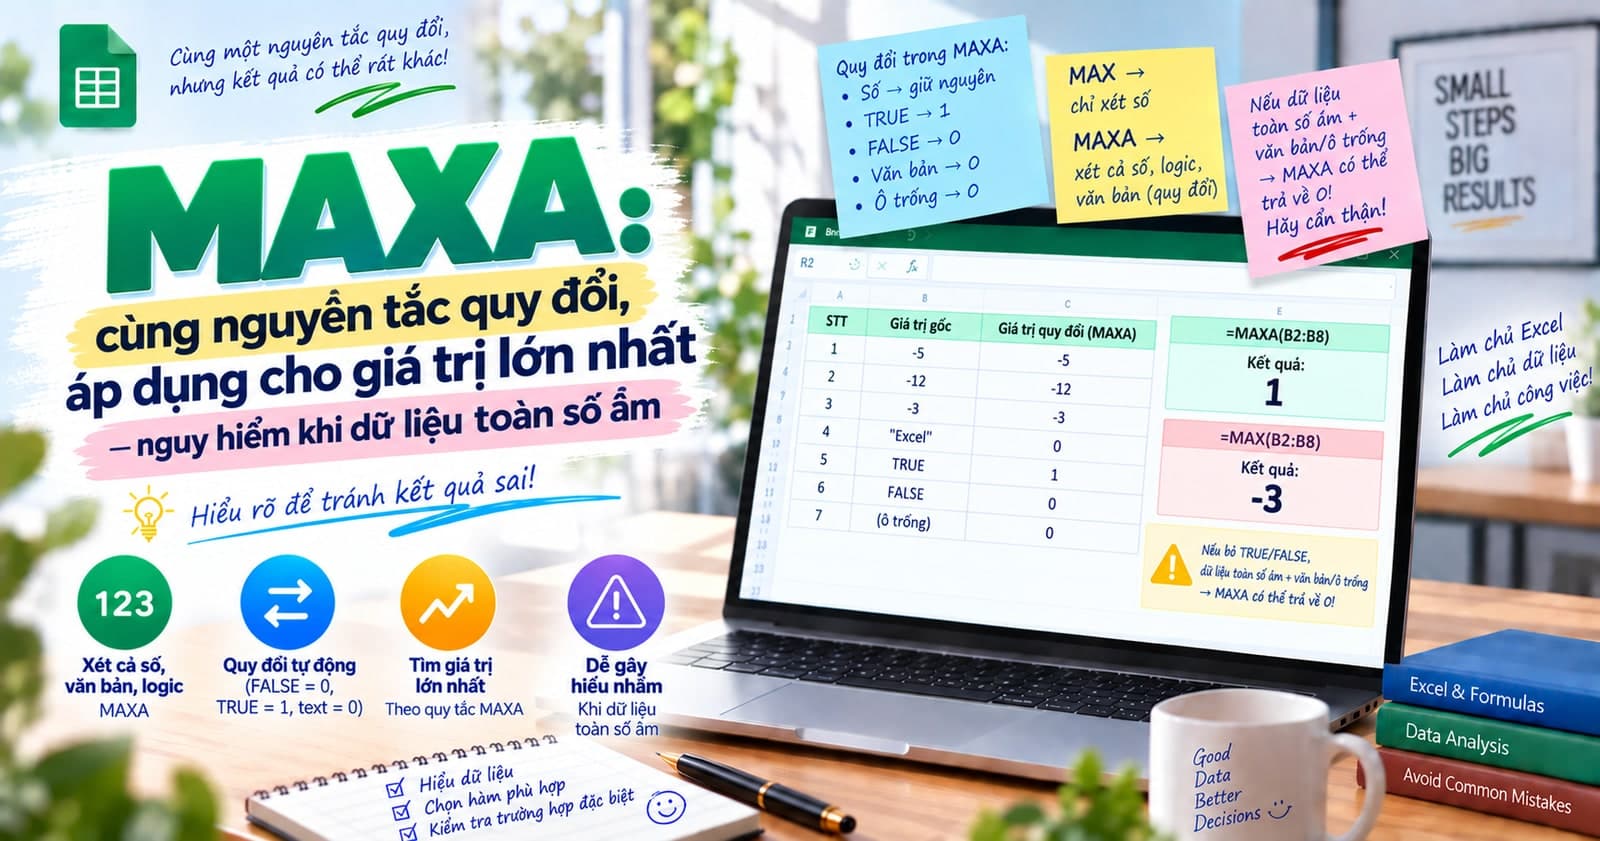
MAXA: cùng nguyên tắc quy đổi, áp dụng cho giá trị lớn nhất — nguy hiểm khi dữ liệu toàn số âm
📗 Excel

MAXA: cùng nguyên tắc quy đổi, áp dụng cho giá trị lớn nhất — nguy hiểm khi dữ liệu toàn số âm

MAXA tìm giá trị lớn nhất như MAX, nhưng tính cả TRUE (=1) và văn bản (=0) thay vì bỏ qua. Nguy hiểm nhất khi dữ liệu toàn số âm — một ô TRUE duy nhất có thể khiến MAXA trả về 1, sai lệch hoàn toàn so với giá trị lớn nhất thực sự.

11 tháng 9, 20263 phút đọc
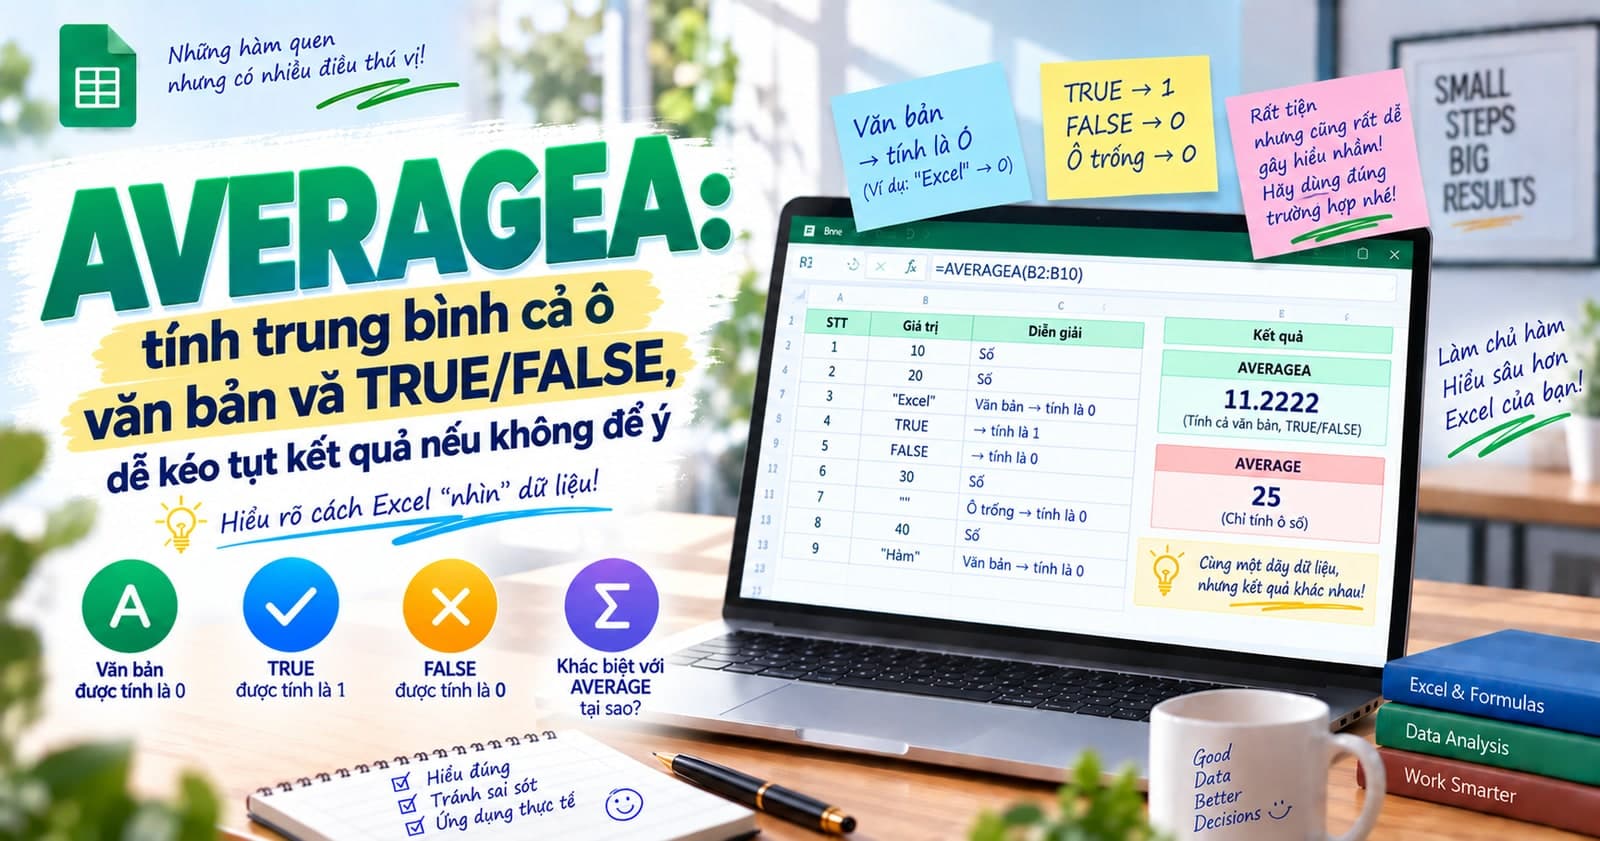
AVERAGEA: tính trung bình cả ô văn bản và TRUE/FALSE, dễ kéo tụt kết quả nếu không để ý
📗 Excel

AVERAGEA: tính trung bình cả ô văn bản và TRUE/FALSE, dễ kéo tụt kết quả nếu không để ý

AVERAGEA tính trung bình như AVERAGE, nhưng không bỏ qua ô văn bản và luận lý — coi TRUE là 1, FALSE và mọi văn bản là 0. Một ô ghi chú tưởng vô hại như 'Chưa chấm' có thể kéo tụt kết quả rất mạnh mà không có dấu hiệu cảnh báo nào.

11 tháng 9, 20263 phút đọc
AVERAGEIFS: tính trung bình khi cần thoả nhiều điều kiện cùng lúc
📗 Excel

AVERAGEIFS: tính trung bình khi cần thoả nhiều điều kiện cùng lúc

AVERAGEIFS mở rộng AVERAGEIF lên nhiều điều kiện cùng lúc — tất cả điều kiện phải cùng thoả mãn. Đặt vùng tính trung bình lên đầu tiên, ngược hẳn với AVERAGEIF, đúng đặc điểm cú pháp RACON.

11 tháng 9, 20263 phút đọc
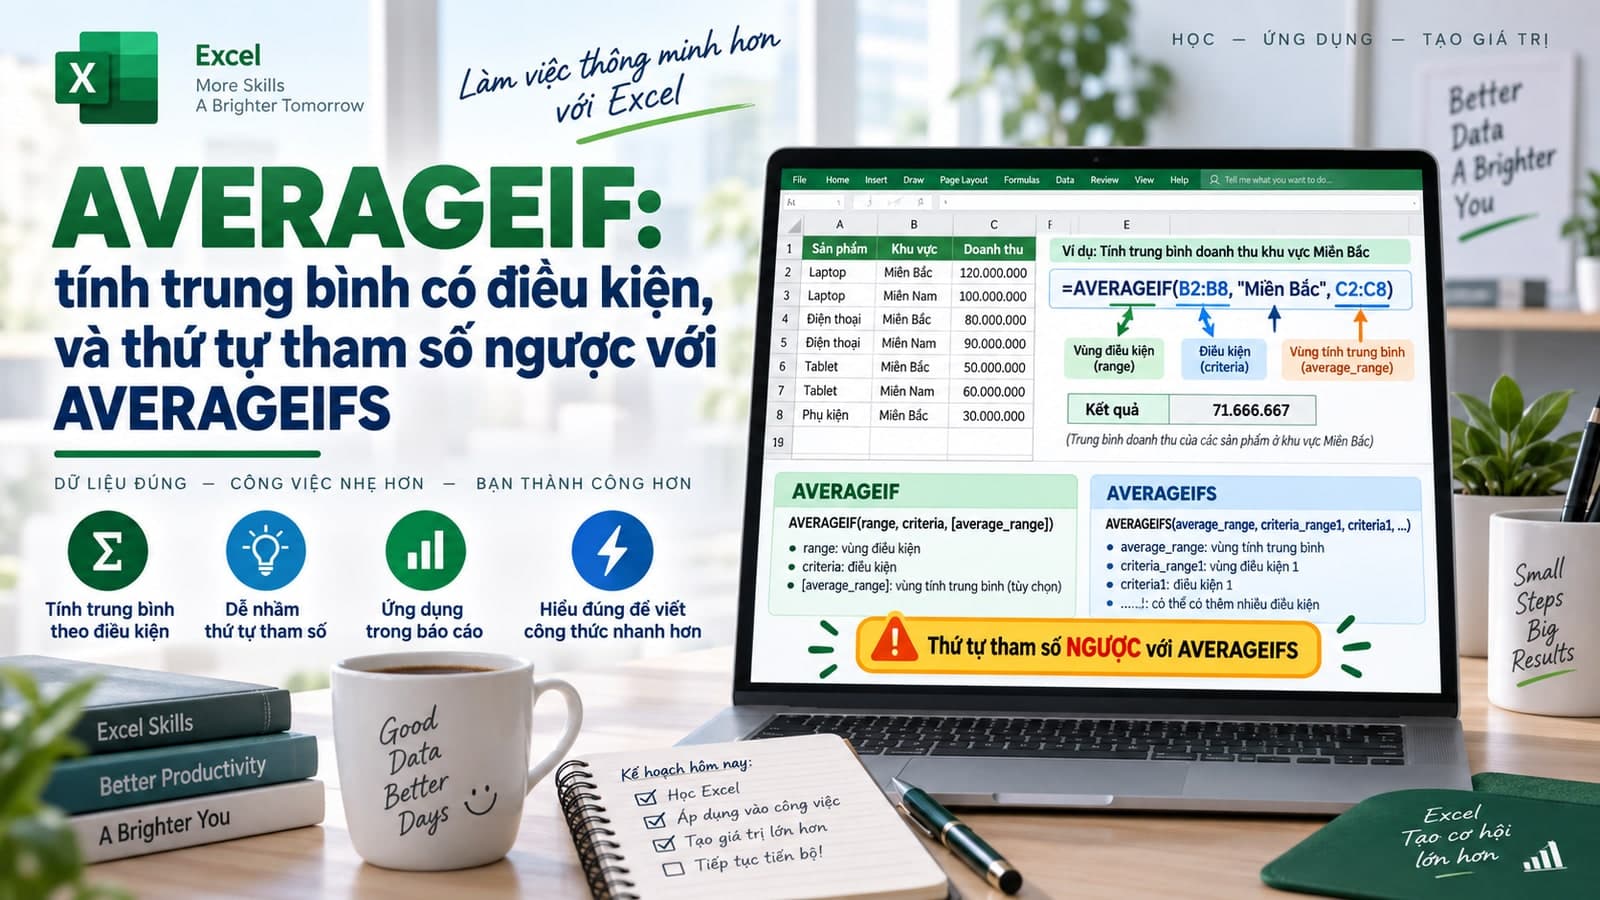
AVERAGEIF: tính trung bình có điều kiện, và thứ tự tham số ngược với AVERAGEIFS
📗 Excel

AVERAGEIF: tính trung bình có điều kiện, và thứ tự tham số ngược với AVERAGEIFS

AVERAGEIF tính trung bình chỉ trên các dòng thoả một điều kiện — giống SUMIF nhưng trả về trung bình thay vì tổng. Cần nhớ thứ tự tham số của AVERAGEIF ngược hẳn với AVERAGEIFS, và kết quả báo lỗi #DIV/0! nếu không có dòng nào khớp.

11 tháng 9, 20263 phút đọc
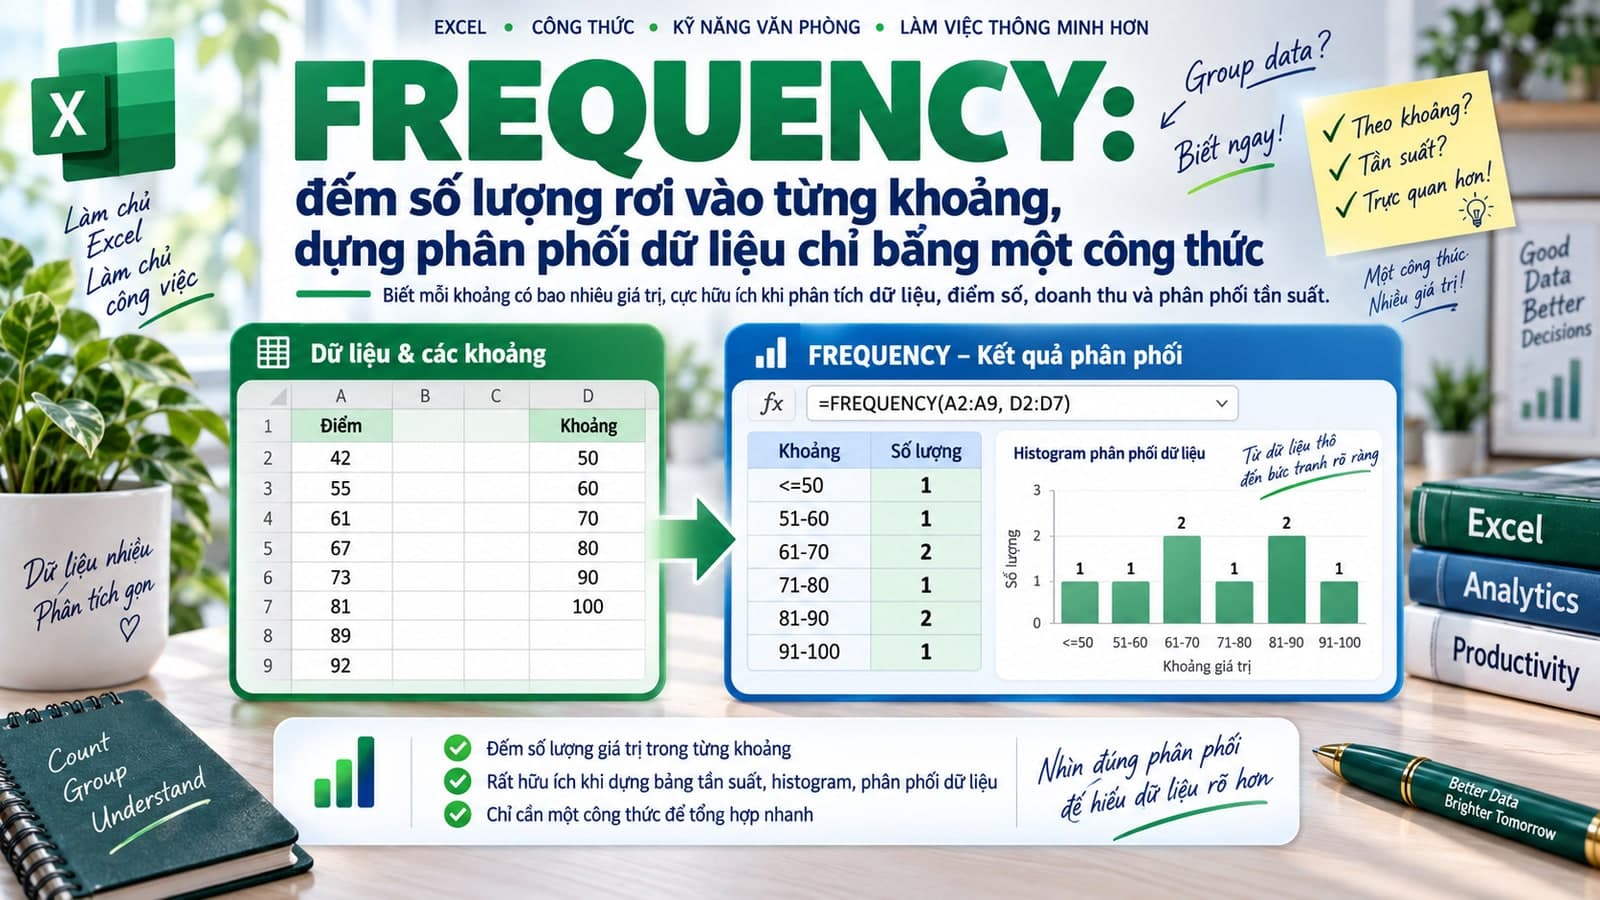
FREQUENCY: đếm số lượng rơi vào từng khoảng, dựng phân phối dữ liệu chỉ bằng một công thức
📗 Excel

FREQUENCY: đếm số lượng rơi vào từng khoảng, dựng phân phối dữ liệu chỉ bằng một công thức

FREQUENCY đếm số lượng giá trị rơi vào từng khoảng do bạn tự định nghĩa, cho ra một phân phối tần suất chỉ với một công thức mảng — thay vì phải viết COUNTIFS riêng cho từng khoảng một cách thủ công.

11 tháng 9, 20263 phút đọc
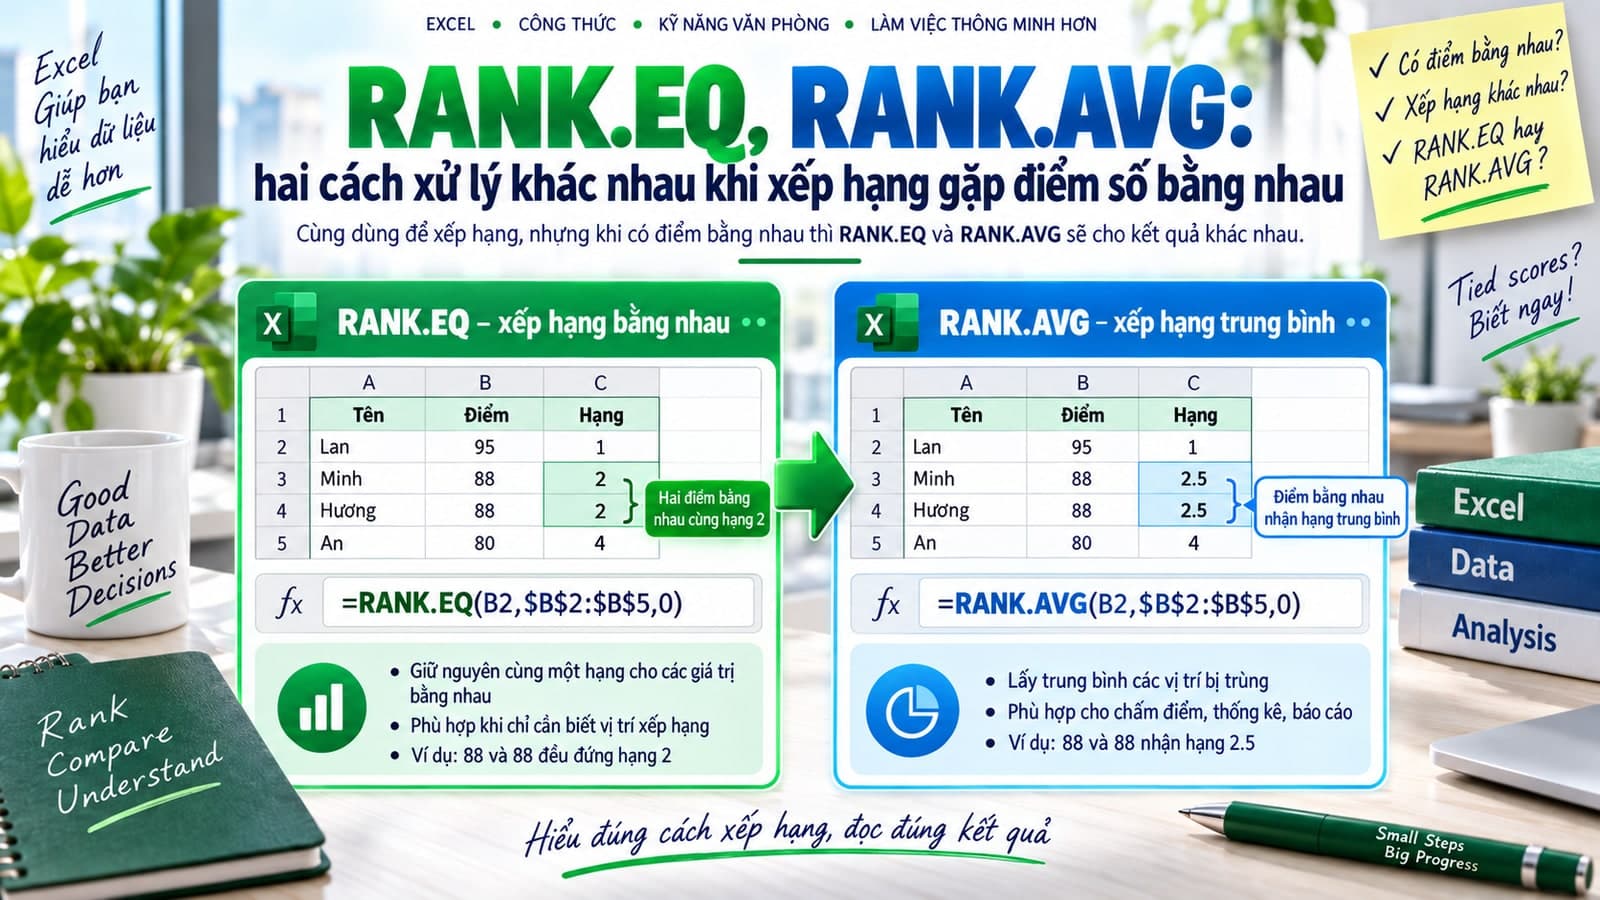
RANK.EQ, RANK.AVG: hai cách xử lý khác nhau khi xếp hạng gặp điểm số bằng nhau
📗 Excel

RANK.EQ, RANK.AVG: hai cách xử lý khác nhau khi xếp hạng gặp điểm số bằng nhau

RANK.EQ và RANK.AVG đều xếp hạng một giá trị trong một danh sách, khác nhau đúng ở cách xử lý khi có nhiều giá trị bằng nhau — RANK.EQ cho các hạng trùng nhau và bỏ qua hạng kế tiếp, RANK.AVG chia đều hạng trung bình.

11 tháng 9, 20263 phút đọc