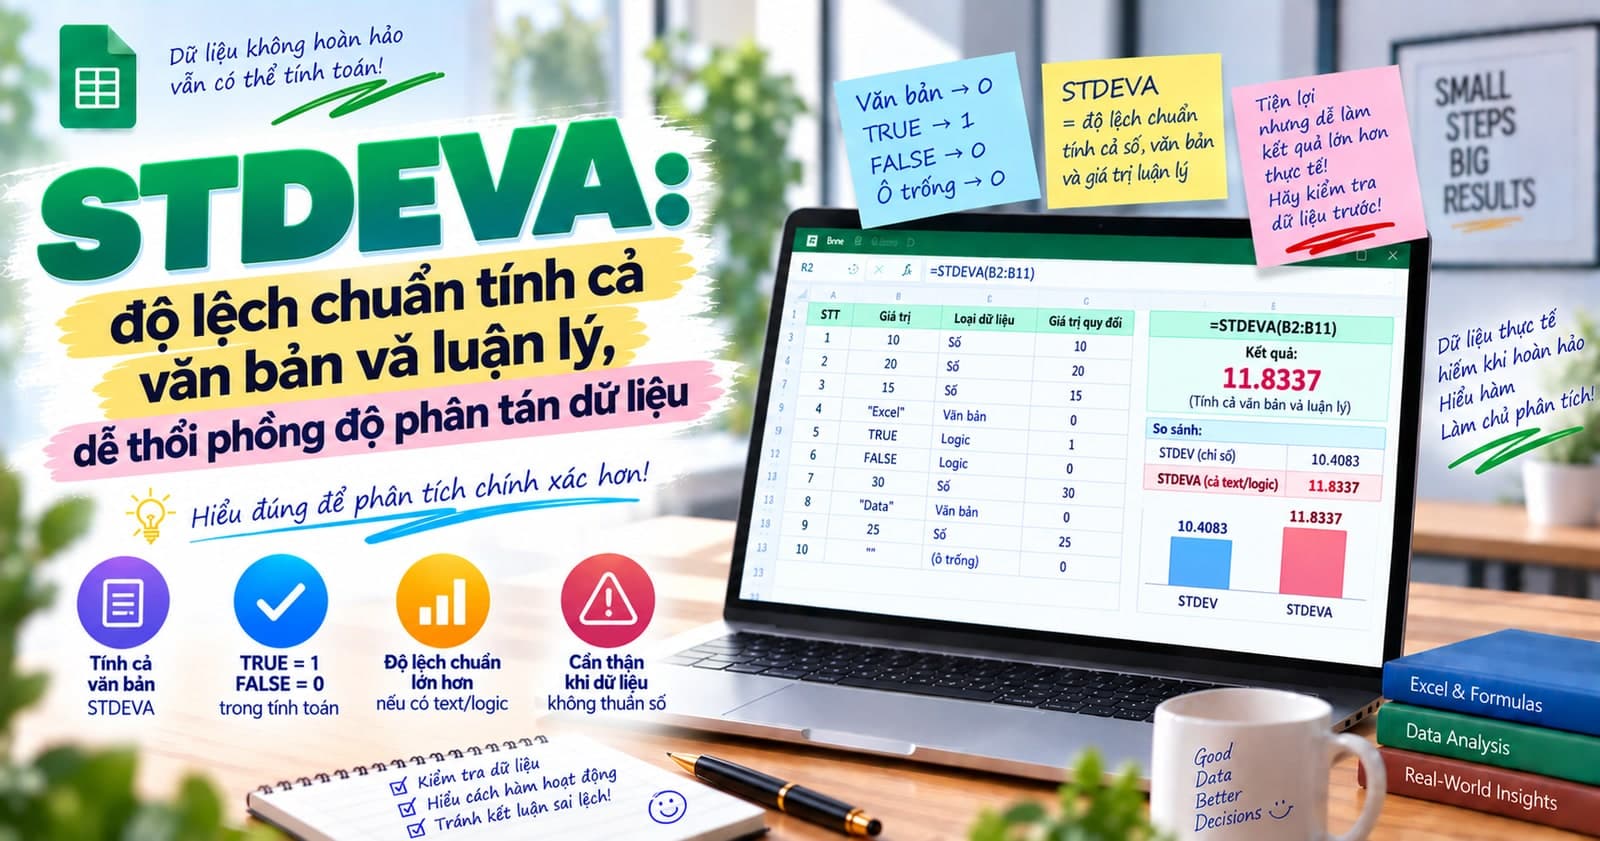
STDEVA: độ lệch chuẩn tính cả văn bản và luận lý, dễ thổi phồng độ phân tán dữ liệu
Chia sẻ
"STDEVA tính độ lệch chuẩn như STDEV, nhưng quy đổi văn bản thành 0 và TRUE thành 1 thay vì bỏ qua — một ô ghi chú lẫn vào dữ liệu số có thể thổi phồng độ lệch chuẩn lên gấp nhiều lần, khiến dữ liệu trông phân tán hơn hẳn thực tế."
Bài trước, MINA khép lại nhóm tìm giá trị lớn/nhỏ nhất. STDEVA chuyển sang một phép tính phức tạp hơn — độ lệch chuẩn — nhưng vẫn giữ nguyên quy tắc quy đổi quen thuộc: văn bản và luận lý không bị bỏ qua như STDEV, mà được tính vào như những con số thật.
Công thức trong bài dùng dấu phẩy (,); đổi sang dấu chấm phẩy (;) nếu Excel của bạn cấu hình theo vùng miền khác.
Cú pháp
=STDEVA(gia_tri1, [gia_tri2], ...)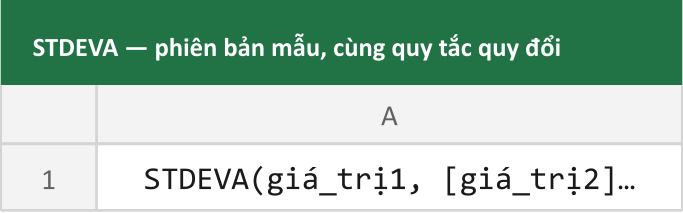
Cùng quy tắc: TRUE=1, FALSE=0, mọi văn bản=0. STDEVA là phiên bản mẫu (sample), tương ứng với STDEV, không phải phiên bản tổng thể (STDEVP).
Một ô văn bản có thể thổi phồng độ lệch chuẩn gấp nhiều lần
Ba học sinh đạt điểm 80, 85, 90 — khá đồng đều. Một học sinh thứ tư chưa có điểm, ghi tạm bằng chữ "Chưa chấm":
=STDEV(80,85,90)
=STDEVA(80,85,90,"Chưa chấm")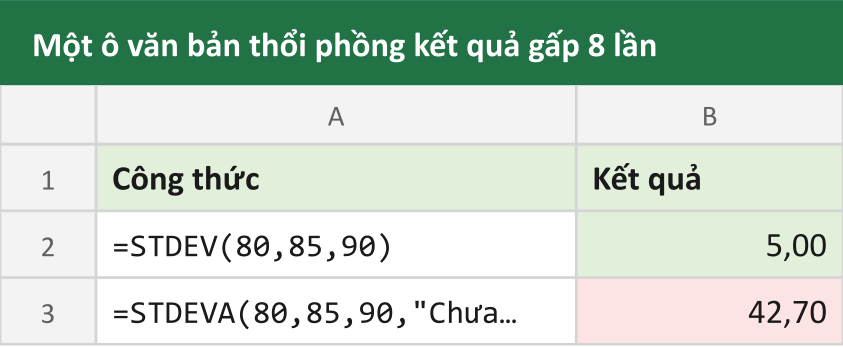
STDEV bỏ qua ô văn bản, cho kết quả 5,00 — phản ánh đúng mức độ đồng đều thực sự của 3 điểm số. STDEVA quy đổi "Chưa chấm" thành 0, biến nó thành một giá trị cách xa hẳn nhóm điểm 80-90, khiến độ lệch chuẩn nhảy vọt lên 42,70 — gấp hơn 8 lần. Dữ liệu trông như phân tán rất mạnh, dù thực chất chỉ vì một ô ghi chú không phải điểm số thật.
Vì sao đây là lỗi nghiêm trọng hơn hẳn so với AVERAGEA
Ở bài AVERAGEA, một ô văn bản kéo trung bình lệch theo tỷ lệ tuyến tính. Với độ lệch chuẩn, phép tính liên quan đến bình phương khoảng cách tới trung bình — một giá trị 0 lạc lõng giữa các số 80-90 tạo ra khoảng cách rất lớn, và khoảng cách đó bị bình phương lên trước khi tính trung bình, khiến sai lệch phóng đại nhanh hơn hẳn so với chỉ tính trung bình thông thường.
Ứng dụng: đo độ phân tán khi checkbox thật sự mang ý nghĩa 0/1
=STDEVA(B2:B20)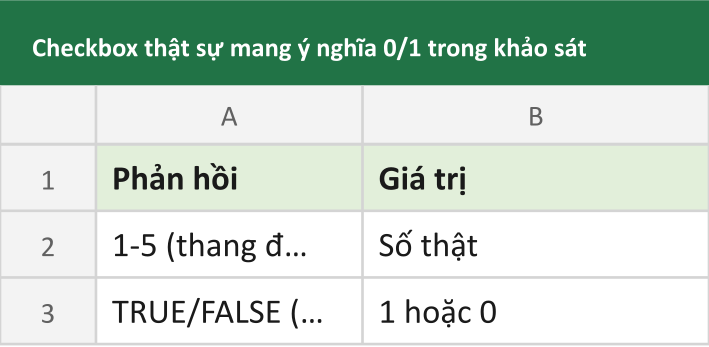
Nếu cột dữ liệu là mức độ hài lòng từ 1 đến 5, trộn với vài ô checkbox biểu thị "hoàn toàn không hài lòng" (FALSE=0) hay "hoàn toàn hài lòng" (TRUE=1), STDEVA phản ánh đúng độ phân tán chung của toàn bộ phản hồi, kể cả những phản hồi ghi bằng checkbox.
Luôn kiểm tra dữ liệu trước khi tin vào STDEVA
=COUNTA(B2:B20)-COUNT(B2:B20)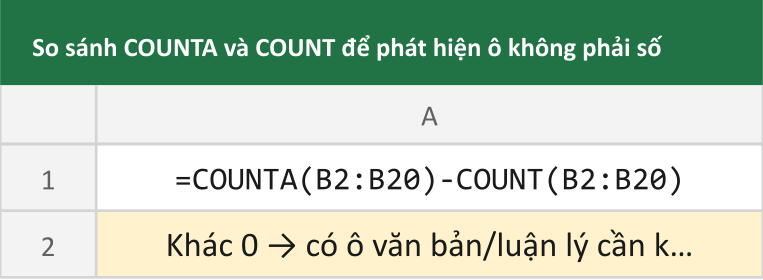
Công thức này đếm số ô không phải số trong vùng dữ liệu (tổng số ô có dữ liệu trừ đi số ô là số) — nếu kết quả khác 0, cần xem lại từng ô đó trước khi tin vào kết quả STDEVA, vì bất kỳ ô văn bản hay luận lý nào cũng có thể đang thổi phồng độ lệch chuẩn một cách âm thầm.
Tổng kết
STDEVA tính độ lệch chuẩn, quy đổi văn bản và luận lý thành số thay vì bỏ qua như STDEV — vì phép tính liên quan đến bình phương khoảng cách, một ô văn bản lạc lõng có thể thổi phồng kết quả gấp nhiều lần chỉ sau một phép quy đổi tưởng như vô hại.
Đọc tiếp trong cùng cụm bài: VARA — phương sai, chính là STDEVA trước khi khai căn.
Mục lục
Muốn làm chủ Excel?
Tham gia khóa học E-Learning của Trà Đá Data để được hướng dẫn chi tiết từ A-Z với Case Study thực tế.
Tìm hiểu ngayBài viết liên quan
Khám phá thêm các bài viết cùng chủ đề
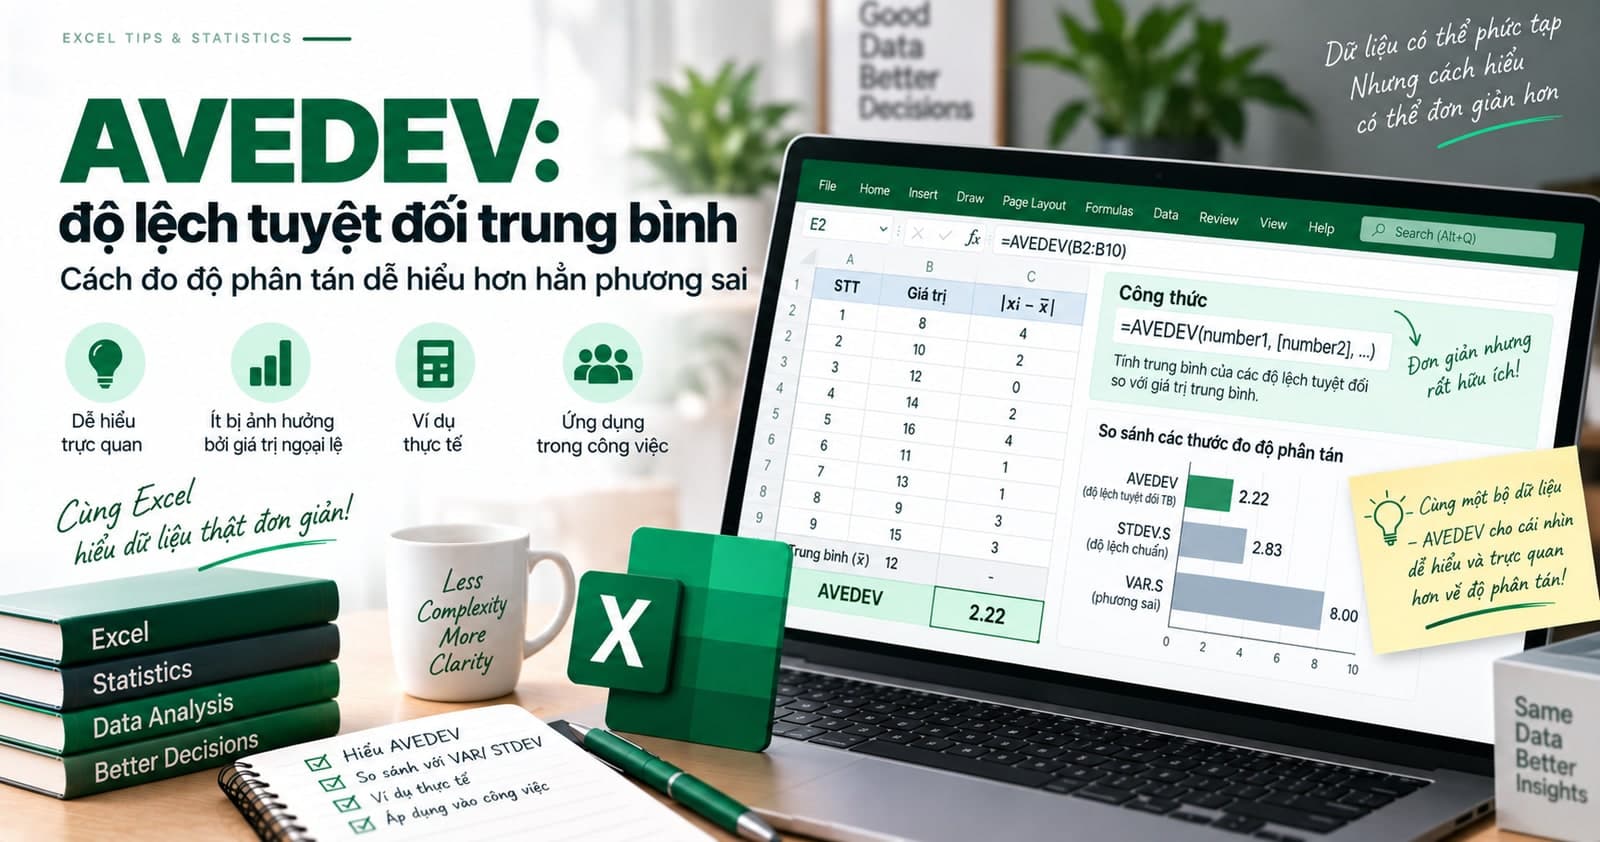
AVEDEV: độ lệch tuyệt đối trung bình, cách đo độ phân tán dễ hiểu hơn hẳn phương sai
AVEDEV đo độ phân tán bằng trung bình của các khoảng cách tuyệt đối tới trung bình — cùng đơn vị với dữ liệu gốc, dễ diễn giải hơn hẳn độ lệch chuẩn vốn phải đi qua bước bình phương rồi khai căn.
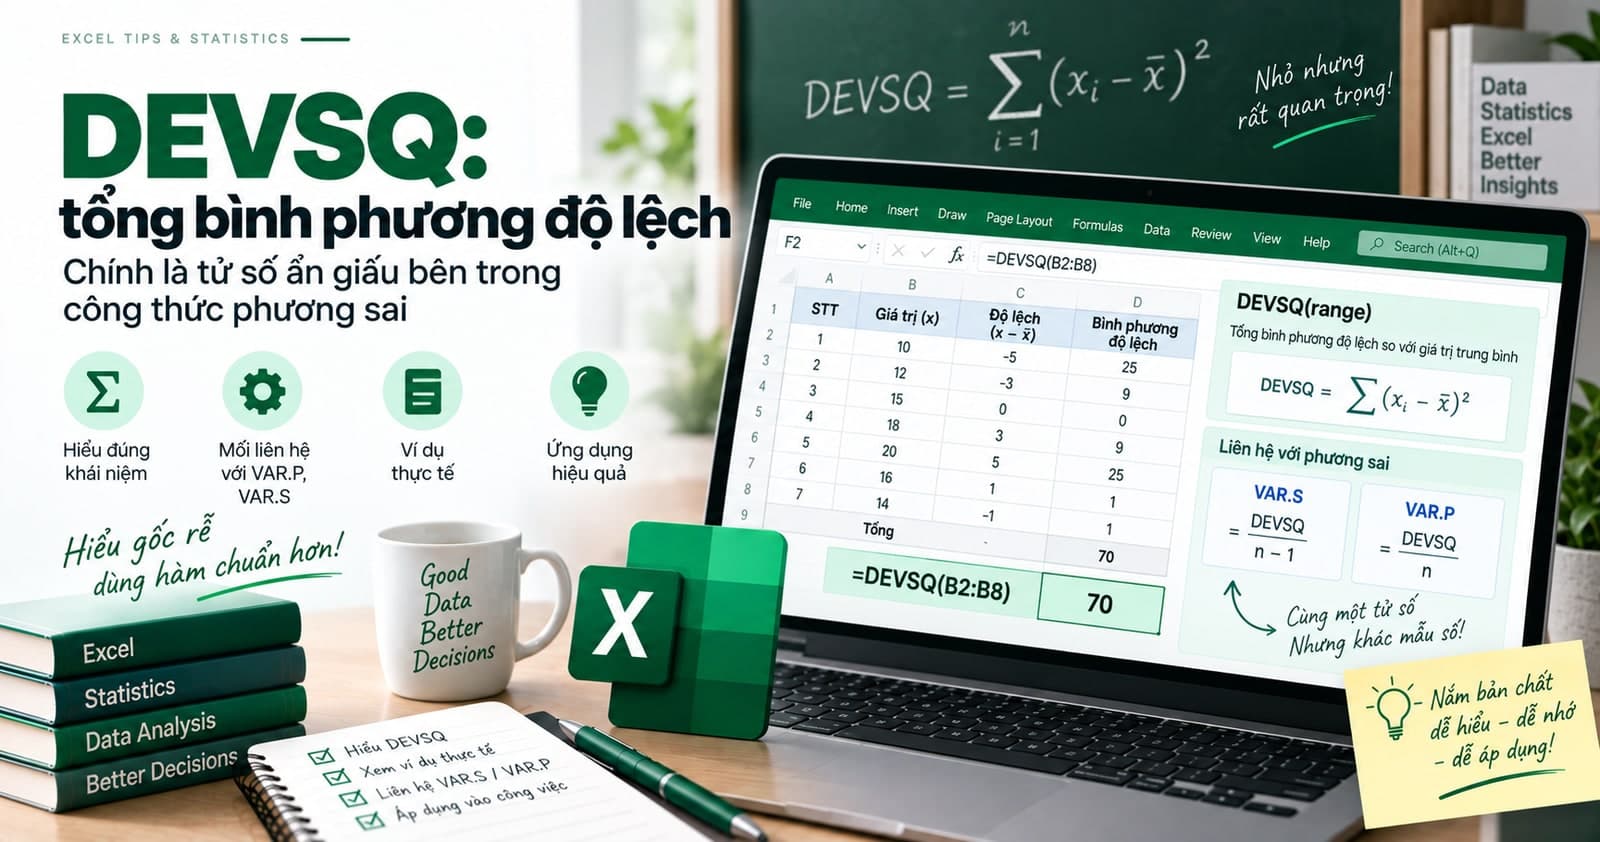
DEVSQ: tổng bình phương độ lệch, chính là tử số ẩn giấu bên trong công thức phương sai
DEVSQ tính tổng bình phương độ lệch so với trung bình — chính là phần tử số trong công thức VAR.P và VAR.S, trước khi chia cho n hoặc n-1. Hữu ích khi cần so sánh trực tiếp mức phân tán tuyệt đối giữa các nhóm cùng cỡ mẫu.
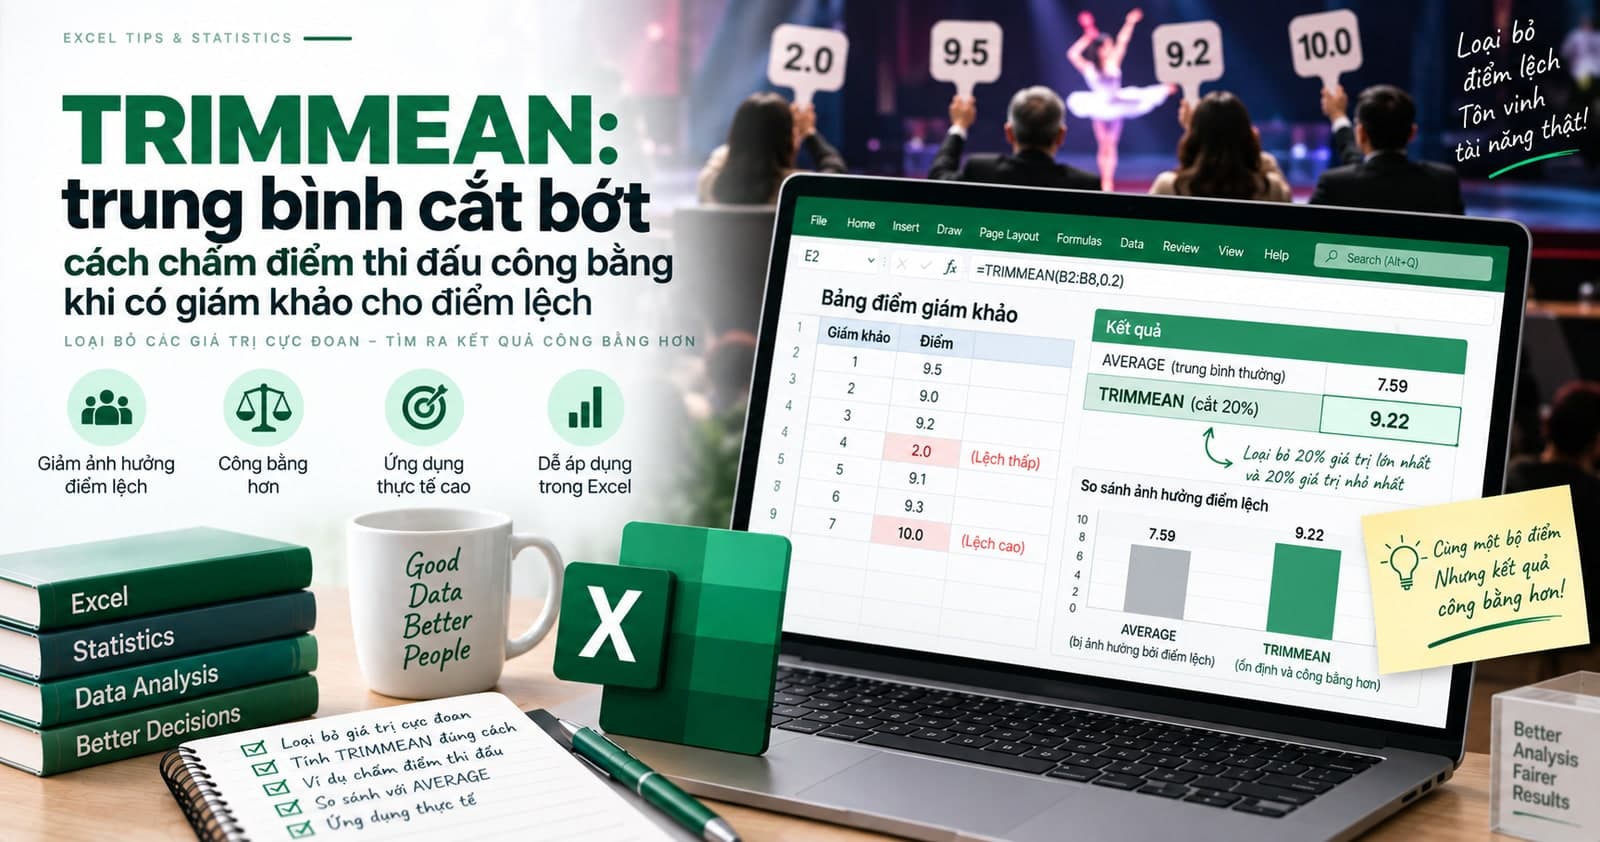
TRIMMEAN: trung bình cắt bớt, cách chấm điểm thi đấu công bằng khi có giám khảo cho điểm lệch
TRIMMEAN loại bỏ một tỷ lệ dữ liệu ở cả hai đầu (cao nhất và thấp nhất) trước khi tính trung bình — đúng cách nhiều cuộc thi thể thao, nghệ thuật chấm điểm để một giám khảo cho điểm quá lệch không làm sai kết quả chung.
Bình luận
Đăng nhập để tham gia bình luận
Đăng nhậpNhận bài viết mới nhất
Đăng ký để nhận thông báo khi có bài viết mới. Không spam, chỉ kiến thức chất lượng.