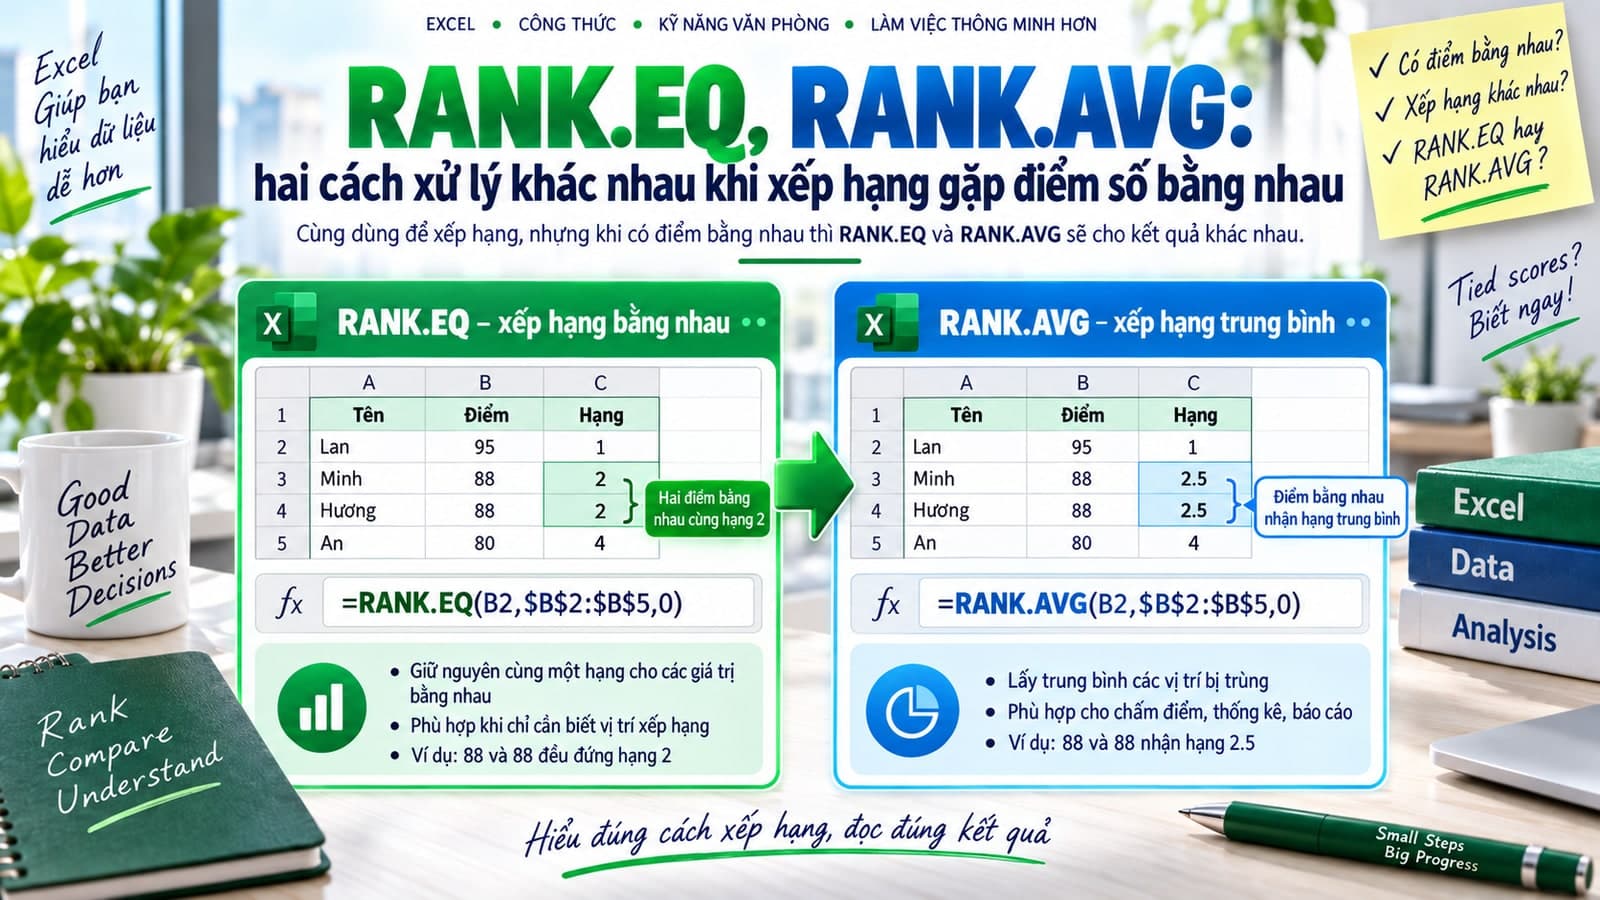
RANK.EQ, RANK.AVG: hai cách xử lý khác nhau khi xếp hạng gặp điểm số bằng nhau
Chia sẻ
"RANK.EQ và RANK.AVG đều xếp hạng một giá trị trong một danh sách, khác nhau đúng ở cách xử lý khi có nhiều giá trị bằng nhau — RANK.EQ cho các hạng trùng nhau và bỏ qua hạng kế tiếp, RANK.AVG chia đều hạng trung bình."
Bài RANK đã giới thiệu cách xếp hạng cơ bản trong Excel. RANK.EQ và RANK.AVG là hai phiên bản mới hơn, thay thế RANK cũ (vẫn còn dùng được để tương thích ngược) — khác nhau đúng một điểm: cách xử lý khi có nhiều giá trị bằng nhau.
Công thức trong bài dùng dấu phẩy (,); đổi sang dấu chấm phẩy (;) nếu Excel của bạn cấu hình theo vùng miền khác.
Cú pháp
=RANK.EQ(so, ref, [thu_tu])
=RANK.AVG(so, ref, [thu_tu])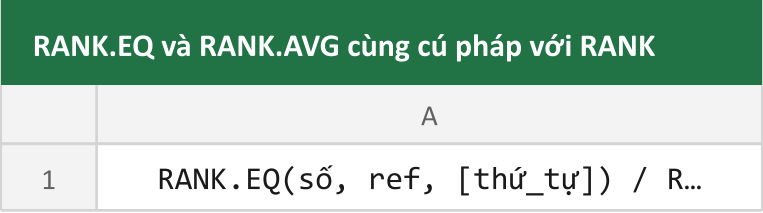
Cả hai đều có cú pháp giống hệt RANK gốc: so là giá trị cần xếp hạng, ref là toàn bộ danh sách, thu_tu là 0 (giảm dần, mặc định) hoặc khác 0 (tăng dần).
Không có giá trị trùng nhau: hai hàm cho kết quả giống hệt nhau
=RANK.EQ(95,B2:B5)
=RANK.AVG(95,B2:B5)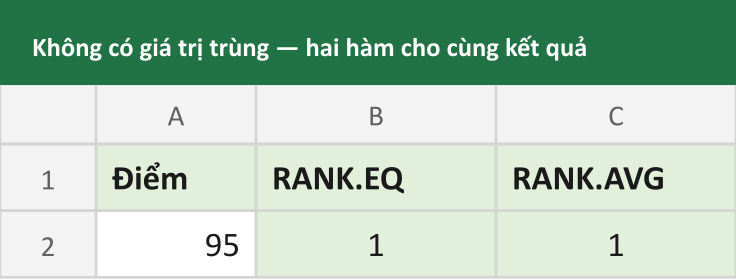
Với danh sách điểm không có giá trị nào trùng nhau, RANK.EQ và RANK.AVG luôn cho ra cùng một kết quả — sự khác biệt giữa hai hàm chỉ lộ ra khi có điểm số bằng nhau.
Có giá trị trùng nhau: RANK.EQ cho hạng trùng, bỏ qua hạng kế tiếp
Danh sách điểm 90, 90, 80, 70 — hai học sinh cùng đạt 90 điểm:
=RANK.EQ(90,B2:B5)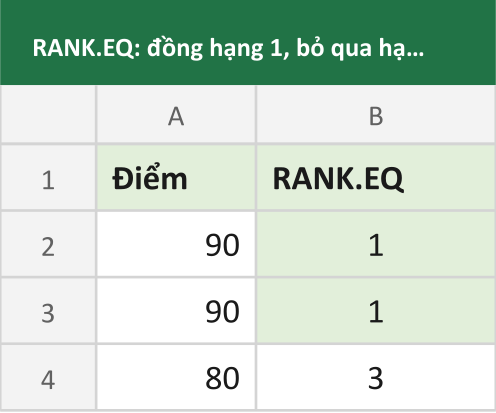
Cả hai điểm 90 đều nhận hạng 1 — đúng kiểu xếp hạng thi đấu thể thao quen thuộc ("đồng hạng nhất"). Nhưng vì đã có hai hạng 1, hạng 2 bị bỏ qua hoàn toàn: điểm 80 xếp thẳng xuống hạng 3, không có ai giữ hạng 2.
RANK.AVG: chia đều hạng trung bình cho các giá trị bằng nhau
=RANK.AVG(90,B2:B5)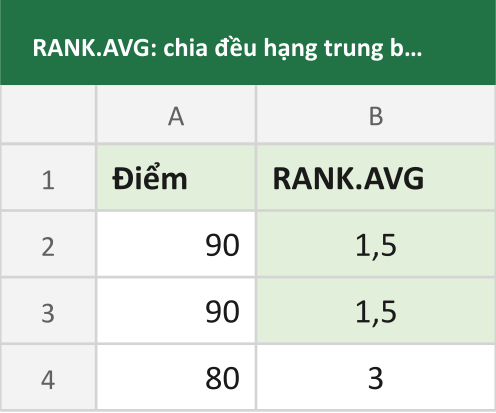
Cùng danh sách đó, RANK.AVG cho cả hai điểm 90 cùng nhận hạng 1,5 — trung bình cộng của hạng 1 và hạng 2 mà lẽ ra hai giá trị này sẽ chiếm nếu chúng nhích lệch nhau một chút. Điểm 80 vẫn xếp hạng 3 ở cả hai cách tính, vì phía trên nó chỉ có đúng hai giá trị lớn hơn.
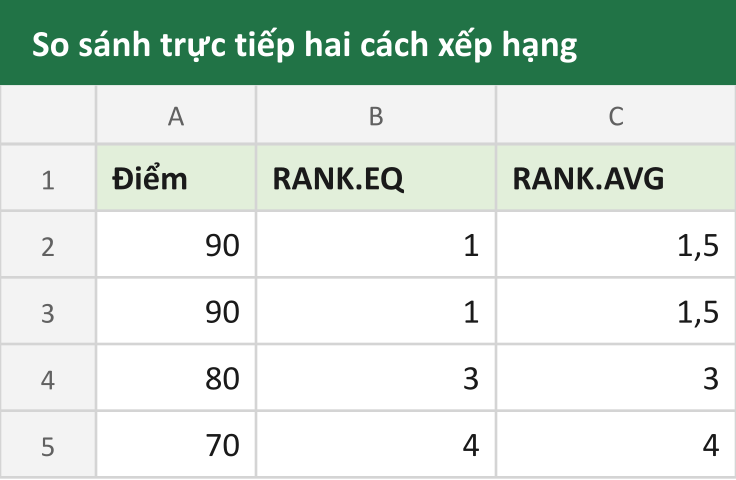
Chọn hàm nào cho đúng ngữ cảnh
Xếp hạng thi đấu, giải thưởng, thứ hạng hiển thị cho người xem (nơi "đồng hạng nhất" là khái niệm quen thuộc, dễ hiểu) →
RANK.EQphù hợp hơn.Tính toán thống kê cần phản ánh đúng vị trí trung bình về mặt số học (ví dụ tính percentile dựa trên hạng) →
RANK.AVGcho kết quả nhất quán hơn về mặt toán học, vì tổng các hạng luôn khớp đúng với tổng1+2+...+nbất kể có bao nhiêu giá trị trùng nhau.
Tổng kết
RANK.EQ và RANK.AVG xếp hạng giống hệt nhau khi không có giá trị trùng lặp, chỉ khác nhau khi gặp điểm số bằng nhau: RANK.EQ gán cùng một hạng cao nhất có thể rồi bỏ qua hạng kế tiếp, còn RANK.AVG chia đều hạng trung bình cho các giá trị bằng nhau đó.
Đọc tiếp trong cùng cụm bài: SORTBY — sắp xếp một danh sách theo tiêu chí nằm ở một cột khác.
Mục lục
Muốn làm chủ Excel?
Tham gia khóa học E-Learning của Trà Đá Data để được hướng dẫn chi tiết từ A-Z với Case Study thực tế.
Tìm hiểu ngayBài viết liên quan
Khám phá thêm các bài viết cùng chủ đề
AVEDEV: độ lệch tuyệt đối trung bình, cách đo độ phân tán dễ hiểu hơn hẳn phương sai
AVEDEV đo độ phân tán bằng trung bình của các khoảng cách tuyệt đối tới trung bình — cùng đơn vị với dữ liệu gốc, dễ diễn giải hơn hẳn độ lệch chuẩn vốn phải đi qua bước bình phương rồi khai căn.
DEVSQ: tổng bình phương độ lệch, chính là tử số ẩn giấu bên trong công thức phương sai
DEVSQ tính tổng bình phương độ lệch so với trung bình — chính là phần tử số trong công thức VAR.P và VAR.S, trước khi chia cho n hoặc n-1. Hữu ích khi cần so sánh trực tiếp mức phân tán tuyệt đối giữa các nhóm cùng cỡ mẫu.
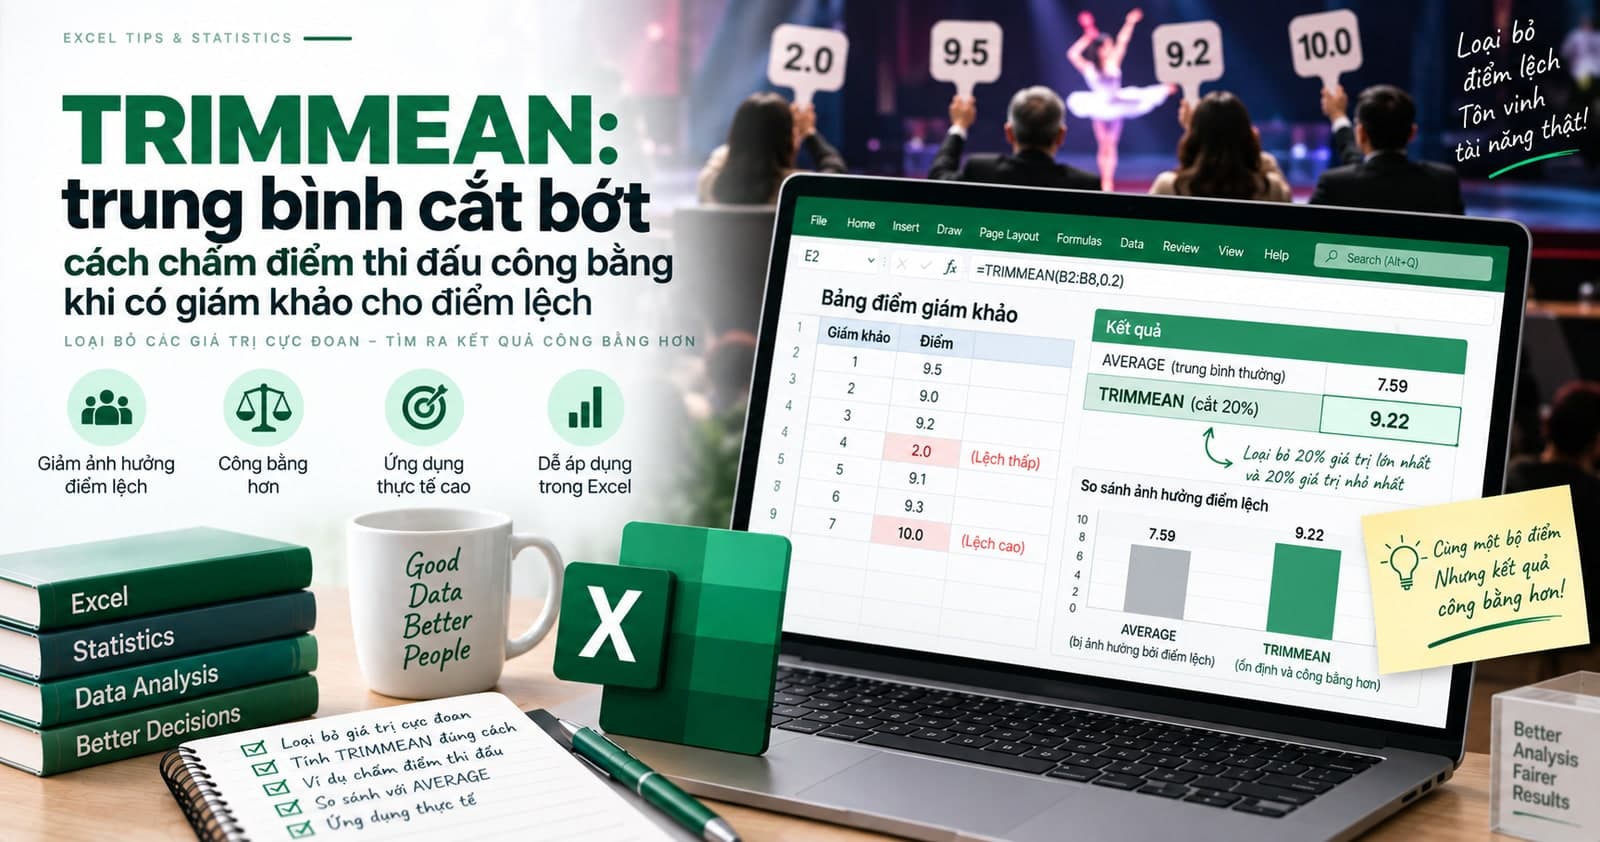
TRIMMEAN: trung bình cắt bớt, cách chấm điểm thi đấu công bằng khi có giám khảo cho điểm lệch
TRIMMEAN loại bỏ một tỷ lệ dữ liệu ở cả hai đầu (cao nhất và thấp nhất) trước khi tính trung bình — đúng cách nhiều cuộc thi thể thao, nghệ thuật chấm điểm để một giám khảo cho điểm quá lệch không làm sai kết quả chung.
Bình luận
Đăng nhập để tham gia bình luận
Đăng nhậpNhận bài viết mới nhất
Đăng ký để nhận thông báo khi có bài viết mới. Không spam, chỉ kiến thức chất lượng.