LINEST: hồi quy tuyến tính đa biến bằng một công thức mảng, và thứ tự hệ số dễ gây nhầm
Chia sẻ
"Cách dùng LINEST để tính hồi quy tuyến tính với nhiều biến độc lập cùng lúc, và vì sao thứ tự hệ số LINEST trả về lại ngược với thứ tự các cột dữ liệu đưa vào."
Bốn bài trước trong cụm đều xoay quanh một biến độc lập duy nhất — chi phí quảng cáo — để giải thích doanh thu. Thực tế thường phức tạp hơn: doanh thu không chỉ phụ thuộc vào chi phí quảng cáo, mà có thể còn phụ thuộc vào số nhân viên bán hàng, mùa vụ, hay nhiều yếu tố khác cùng lúc.
LINEST là hàm duy nhất trong cụm bài này xử lý được trường hợp có nhiều hơn một biến độc lập — hồi quy tuyến tính đa biến — chỉ bằng một công thức mảng duy nhất. Đổi lại, nó có một quy ước sắp xếp kết quả dễ gây nhầm lẫn nhất trong cả cụm bài.
Công thức viết bằng dấu phẩy (,); đổi sang dấu chấm phẩy (;) nếu Excel của bạn cấu hình theo vùng miền khác.
Bộ dữ liệu dùng trong bài
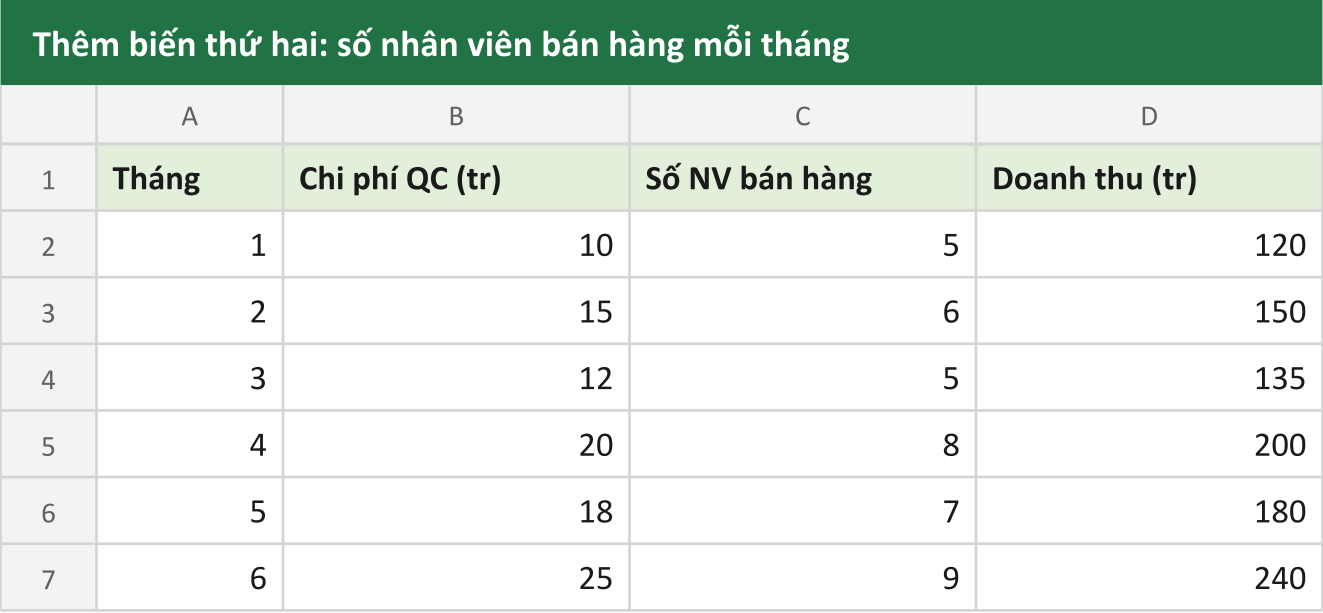
Mở rộng dữ liệu 6 tháng đã dùng xuyên suốt cụm bài, thêm một cột: số nhân viên bán hàng mỗi tháng.
Cú pháp LINEST
=LINEST(known_ys, known_xs, [const], [stats])known_ys— vùng chứa biến phụ thuộc, một cột duy nhất (doanh thu).known_xs— vùng chứa các biến độc lập, có thể nhiều cột cùng lúc (chi phí quảng cáo và số nhân viên).const—TRUE(mặc định) để tính cả hệ số chặn (intercept);FALSEđể ép hệ số chặn về0.stats—TRUEđể trả về thêm các chỉ số thống kê phụ (sai số chuẩn, R², v.v.);FALSE(mặc định) chỉ trả về các hệ số.
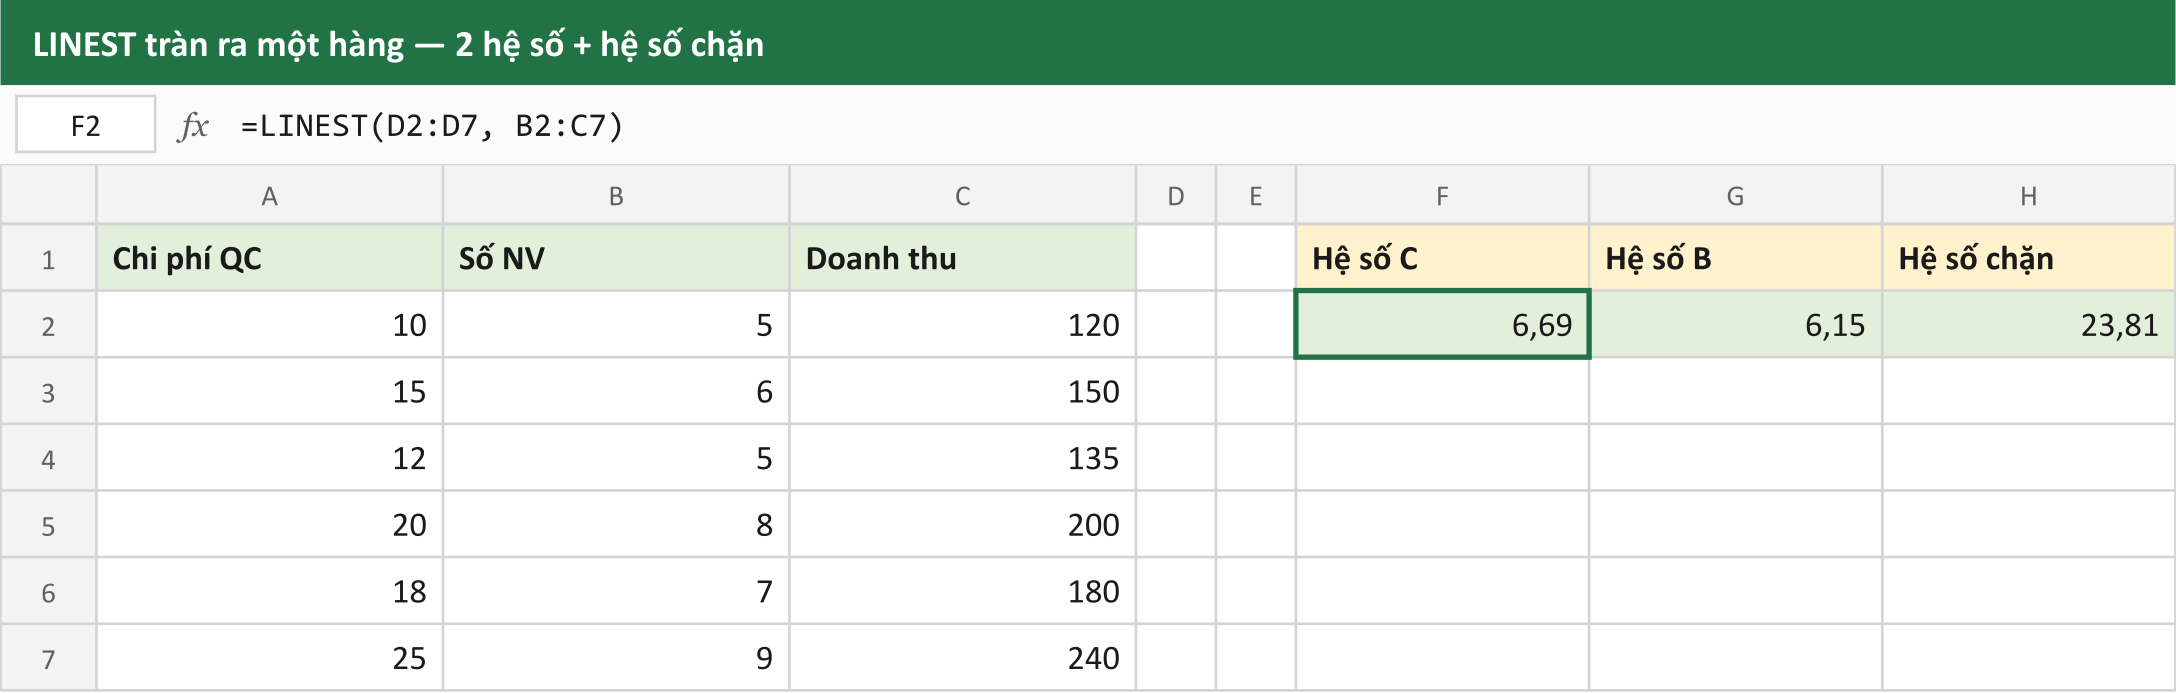
=LINEST(D2:D7, B2:C7, TRUE, TRUE)Vì LINEST trả về nhiều ô kết quả cùng lúc, cần chọn trước một vùng đủ rộng rồi nhập công thức bằng tổ hợp phím Ctrl + Shift + Enter trên các bản Excel không phải Microsoft 365 (thiếu bước này, Excel chỉ hiện đúng một ô kết quả, cắt mất phần còn lại). Với Microsoft 365, LINEST tự động tràn (spill) ra các ô lân cận, không cần tổ hợp phím đặc biệt.
Đọc kết quả: hệ số ra theo thứ tự NGƯỢC
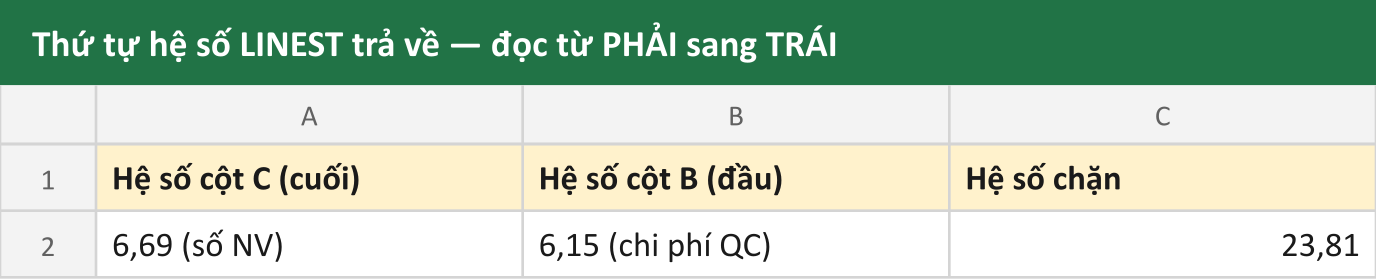
Đây là điều quan trọng nhất cần nhớ khi dùng LINEST, và là nguồn nhầm lẫn phổ biến nhất: dòng đầu tiên của kết quả liệt kê hệ số theo thứ tự ngược lại với thứ tự cột trong known_xs, và hệ số chặn luôn nằm ở vị trí cuối cùng.
Với known_xs là B2:C7 — cột B là chi phí quảng cáo, cột C là số nhân viên — dòng kết quả đầu tiên của LINEST trả về theo thứ tự:
[hệ số của cột C] [hệ số của cột B] [hệ số chặn]Tức là hệ số của cột cuối cùng trong known_xs hiện ra đầu tiên, và hệ số chặn luôn đứng sau cùng — không đứng đầu như nhiều người quen nghĩ theo dạng y = b + m1×x1 + m2×x2.
Với dữ liệu ví dụ, kết quả xấp xỉ:
6,69        6,15        23,81
(số NV)     (chi phí QC)   (hệ số chặn)
Đọc thành phương trình đầy đủ:
Doanh thu ≈ 23,81 + 6,15 × Chi phí quảng cáo + 6,69 × Số nhân viên bán hàngNếu không để ý thứ tự ngược này, rất dễ gán nhầm hệ số 6,69 cho chi phí quảng cáo và 6,15 cho số nhân viên — hai hệ số vẫn là số hợp lệ, chỉ là gán sai biến, dẫn tới diễn giải hoàn toàn sai về việc yếu tố nào đang tác động mạnh hơn.
Cách kiểm tránh nhầm: luôn đối chiếu ngược từ phải sang trái — ô cuối cùng bên phải là hệ số chặn, ô ngay trước nó là hệ số của cột đầu tiên trong known_xs, cứ thế lùi dần về bên trái cho tới cột cuối cùng trong known_xs nằm ở vị trí ngoài cùng bên trái của dòng kết quả.
Đọc hai hệ số vừa tìm được
Với const=TRUE và bỏ qua sai số ước lượng, phương trình đa biến cho biết: giữ nguyên số nhân viên bán hàng, mỗi 1 triệu đồng chi thêm cho quảng cáo gắn với khoảng 6,15 triệu đồng doanh thu tăng thêm. Giữ nguyên chi phí quảng cáo, mỗi nhân viên bán hàng thêm vào gắn với khoảng 6,69 triệu đồng doanh thu tăng thêm.
Đây chính là điểm khác biệt cốt lõi giữa hồi quy đơn biến (SLOPE ở bài trước) và hồi quy đa biến: hệ số 6,15 của chi phí quảng cáo trong mô hình đa biến này khác với hệ số 8,11 tính riêng bằng SLOPE ở bài 2, vì giờ đây phần ảnh hưởng có thể trùng lặp giữa chi phí quảng cáo và số nhân viên bán hàng (hai biến này bản thân cũng có thể tương quan với nhau — công ty tăng ngân sách quảng cáo thường cũng tuyển thêm người) đã được tách bạch ra, mỗi hệ số giờ phản ánh ảnh hưởng riêng của biến đó sau khi đã giữ cố định biến còn lại.
Bật thêm stats để lấy R² và sai số chuẩn
Khi stats=TRUE, LINEST trả về thêm 4 dòng chỉ số thống kê phụ bên dưới dòng hệ số, trong đó dòng thứ ba, cột đầu tiên là R² của mô hình đa biến — cùng ý nghĩa như RSQ đã nói ở bài trước, nhưng giờ đo độ khớp của cả hai biến cùng lúc thay vì một biến đơn lẻ.
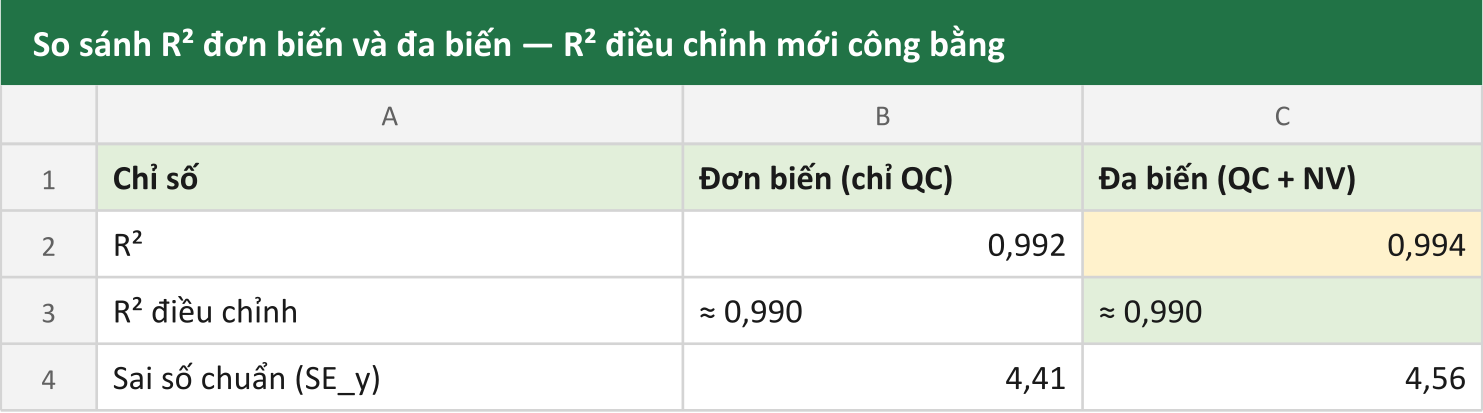
So sánh R² của mô hình đa biến này với R² của mô hình đơn biến (chỉ chi phí quảng cáo) ở bài RSQ cần thận trọng đúng như đã cảnh báo: thêm bất kỳ biến nào — kể cả biến không thật sự hữu ích — gần như luôn làm R² tăng lên. Muốn biết việc thêm biến "số nhân viên bán hàng" có thật sự đáng giá hay không, cần nhìn vào R² điều chỉnh (dòng đầu tiên, cột thứ hai trong khối stats), vì chỉ số này có phạt thêm cho mỗi biến được thêm vào mô hình, cho một phép so sánh công bằng hơn giữa mô hình 1 biến và mô hình 2 biến.
Tổng kết
LINEST mở rộng hồi quy tuyến tính từ một biến sang nhiều biến cùng lúc, chỉ bằng một công thức mảng duy nhất — nhưng cái giá phải trả là một quy ước sắp xếp kết quả dễ gây nhầm: hệ số ra theo thứ tự ngược với thứ tự cột trong known_xs, và hệ số chặn luôn nằm ở vị trí cuối cùng bên phải. Luôn đối chiếu từ phải sang trái để gán đúng hệ số cho đúng biến.
Đây là bài cuối trong cụm 5 bài về hồi quy tuyến tính trong Excel. Xem lại từ đầu: CORREL — đo mức độ tương quan, SLOPE và INTERCEPT — dựng phương trình, RSQ — đo độ khớp mô hình, STEYX — sai số chuẩn của dự đoán.
Mục lục
Muốn làm chủ Excel?
Tham gia khóa học E-Learning của Trà Đá Data để được hướng dẫn chi tiết từ A-Z với Case Study thực tế.
Tìm hiểu ngayBài viết liên quan
Khám phá thêm các bài viết cùng chủ đề
STEYX: sai số chuẩn của mô hình hồi quy, và khoảng dao động thực tế của một dự đoán
Cách dùng STEYX để biết một dự đoán từ mô hình hồi quy thường lệch bao nhiêu so với thực tế, tính theo đúng đơn vị gốc thay vì phần trăm trừu tượng như RSQ.
RSQ: R² đo được bao nhiêu phần trăm biến thiên mô hình giải thích được
Cách dùng RSQ để đo mức độ khớp của một mô hình hồi quy tuyến tính, đọc đúng ý nghĩa phần trăm biến thiên được giải thích, và vì sao R² cao không có nghĩa là mô hình tốt cho mọi mục đích.
SLOPE và INTERCEPT: tự tay dựng phương trình hồi quy tuyến tính
Cách dùng SLOPE và INTERCEPT để dựng phương trình đường thẳng y = mx + b từ dữ liệu thực tế, và cách đọc đúng ý nghĩa của độ dốc khi dự đoán một giá trị mới.
Bình luận
Đăng nhập để tham gia bình luận
Đăng nhậpNhận bài viết mới nhất
Đăng ký để nhận thông báo khi có bài viết mới. Không spam, chỉ kiến thức chất lượng.