RSQ: R² đo được bao nhiêu phần trăm biến thiên mô hình giải thích được
Chia sẻ
"Cách dùng RSQ để đo mức độ khớp của một mô hình hồi quy tuyến tính, đọc đúng ý nghĩa phần trăm biến thiên được giải thích, và vì sao R² cao không có nghĩa là mô hình tốt cho mọi mục đích."
Hai bài trước đã dựng được một phương trình cụ thể — Doanh thu ≈ 8,11 × Chi phí quảng cáo + 35,74 — từ dữ liệu 6 tháng. Nhưng phương trình nào cũng vẽ được một đường thẳng qua dữ liệu; câu hỏi còn thiếu là: đường thẳng đó khớp với dữ liệu thực tế tốt tới đâu?
RSQ — thường gọi là R bình phương, hay R² — trả lời đúng câu hỏi đó bằng một con số duy nhất, dễ đọc hơn CORREL rất nhiều vì nó có ý nghĩa phần trăm cụ thể.
Công thức viết bằng dấu phẩy (,); đổi sang dấu chấm phẩy (;) nếu Excel của bạn cấu hình theo vùng miền khác.
Bộ dữ liệu dùng trong bài
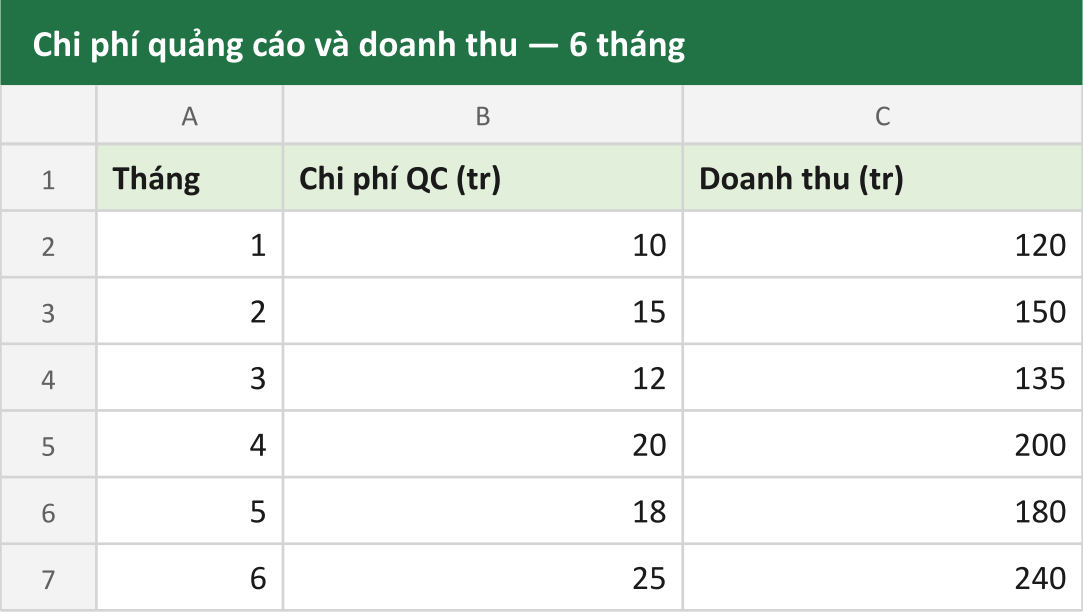
Vẫn dùng dữ liệu chi phí quảng cáo (cột B) và doanh thu (cột C) của 6 tháng, xuyên suốt cụm bài.
Cú pháp và cách đọc kết quả
=RSQ(known_ys, known_xs)Cùng thứ tự tham số như SLOPE và INTERCEPT ở bài trước: y trước, x sau.
=RSQ(C2:C7, B2:B7)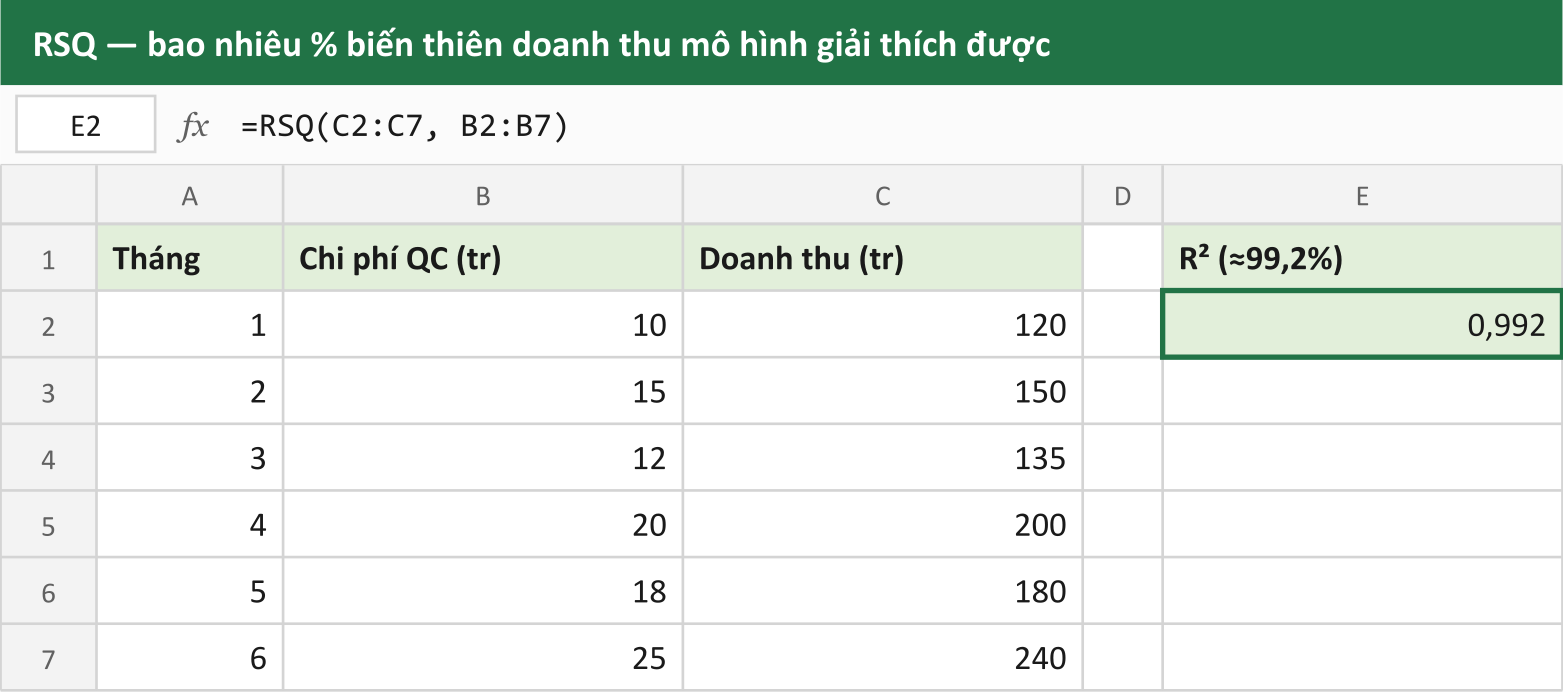
Kết quả xấp xỉ 0,992. RSQ luôn nằm trong khoảng từ 0 đến 1, và ý nghĩa của nó là tỷ lệ phần trăm biến thiên của y được giải thích bởi x thông qua mô hình tuyến tính. Nhân với 100, con số 0,992 có nghĩa: khoảng 99,2% sự biến động của doanh thu giữa các tháng được giải thích bởi sự biến động của chi phí quảng cáo. Chỉ còn khoảng 0,8% biến thiên còn lại đến từ những yếu tố khác không nằm trong mô hình — mùa vụ, đối thủ cạnh tranh, ngẫu nhiên.
Quan hệ giữa RSQ và CORREL
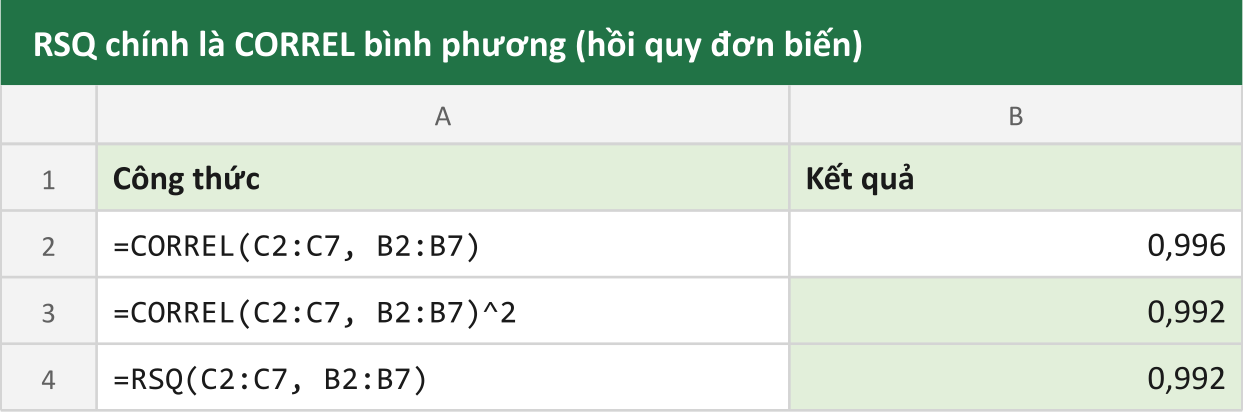
Nếu để ý, 0,992 gần đúng bằng bình phương của 0,996 — hệ số tương quan đã tính ở bài đầu cụm. Đây không phải trùng hợp: RSQ chính là bình phương của CORREL trong trường hợp hồi quy tuyến tính đơn biến (chỉ một biến x).
=CORREL(C2:C7, B2:B7)^2Công thức này cho kết quả giống hệt RSQ(C2:C7, B2:B7). Biết được mối quan hệ này giúp hiểu vì sao khi bình phương một hệ số tương quan, con số luôn nhỏ đi (trừ khi tương quan tuyệt đối bằng 1 hoặc -1) — và đó chính là lý do R² luôn có vẻ "khắt khe" hơn hệ số tương quan gốc.
R² cao có nghĩa là mô hình tốt, nhưng chưa chắc hữu ích
Đây là điều dễ hiểu lầm nhất khi dùng R² để đánh giá một mô hình. R² cao chỉ nói rằng đường thẳng khớp tốt với dữ liệu đã quan sát — nó không tự động đảm bảo mô hình sẽ dự đoán tốt cho dữ liệu mới, và cũng không đảm bảo mô hình có ý nghĩa thực tế.
Ba tình huống cụ thể cần cẩn thận:
R² cao vì mẫu dữ liệu quá nhỏ. Với chỉ 6 điểm dữ liệu như ví dụ trong bài, một đường thẳng dễ khớp "đẹp" hơn nhiều so với khi có 60 hoặc 600 điểm dữ liệu thực tế trải rộng và nhiễu hơn. Càng ít điểm dữ liệu, R² càng dễ bị đẩy lên cao một cách giả tạo — không phải vì quan hệ thật sự chặt, mà vì chưa đủ dữ liệu để bộc lộ độ nhiễu thật.
R² cao nhưng biến x không có ý nghĩa nhân quả. Đúng như đã nói ở bài CORREL, một biến hoàn toàn không liên quan về mặt logic vẫn có thể ngẫu nhiên cho ra R² cao trên một tập dữ liệu nhỏ, đặc biệt khi cả hai biến cùng có xu hướng tăng theo thời gian.
So sánh R² giữa các mô hình khác biến số là không công bằng. Thêm bất kỳ biến nào vào một mô hình hồi quy — kể cả biến hoàn toàn ngẫu nhiên, không liên quan gì — hầu như luôn làm R² tăng lên hoặc giữ nguyên, không bao giờ giảm. Vì vậy so sánh R² giữa một mô hình có 1 biến và một mô hình có 5 biến để kết luận "mô hình 5 biến tốt hơn" là một phép so sánh sai lệch. Đây là lý do dân thống kê thường dùng thêm chỉ số "R² điều chỉnh" (adjusted R², xuất hiện trong kết quả của LINEST mà bài cuối cụm sẽ nói tới) khi so sánh các mô hình có số biến khác nhau.
Tổng kết
RSQ đo tỷ lệ phần trăm biến thiên của biến phụ thuộc mà mô hình tuyến tính giải thích được, và với hồi quy đơn biến, nó chính bằng bình phương của hệ số tương quan CORREL. R² cao là dấu hiệu tốt cho việc đường thẳng khớp với dữ liệu đã có, nhưng không tự động chứng minh mô hình dự đoán tốt cho dữ liệu mới, và càng không nên dùng để so sánh trực tiếp giữa các mô hình có số lượng biến khác nhau.
Đọc tiếp trong cùng cụm bài: R² cho biết mô hình khớp bao nhiêu phần trăm, còn sai số dự đoán tính bằng đơn vị gốc là bao nhiêu — xem STEYX: sai số chuẩn của mô hình hồi quy. Quay lại bước dựng phương trình ở SLOPE và INTERCEPT.
Mục lục
Muốn làm chủ Excel?
Tham gia khóa học E-Learning của Trà Đá Data để được hướng dẫn chi tiết từ A-Z với Case Study thực tế.
Tìm hiểu ngayBài viết liên quan
Khám phá thêm các bài viết cùng chủ đề
STEYX: sai số chuẩn của mô hình hồi quy, và khoảng dao động thực tế của một dự đoán
Cách dùng STEYX để biết một dự đoán từ mô hình hồi quy thường lệch bao nhiêu so với thực tế, tính theo đúng đơn vị gốc thay vì phần trăm trừu tượng như RSQ.
SLOPE và INTERCEPT: tự tay dựng phương trình hồi quy tuyến tính
Cách dùng SLOPE và INTERCEPT để dựng phương trình đường thẳng y = mx + b từ dữ liệu thực tế, và cách đọc đúng ý nghĩa của độ dốc khi dự đoán một giá trị mới.
Hàm CORREL: đo mức độ tương quan giữa hai biến, và vì sao tương quan không phải nhân quả
Cách dùng CORREL để đo mức độ hai biến số di chuyển cùng nhau chặt chẽ tới đâu, đọc đúng khoảng giá trị từ -1 đến 1, và vì sao một hệ số tương quan cao không chứng minh được quan hệ nhân quả.
Bình luận
Đăng nhập để tham gia bình luận
Đăng nhậpNhận bài viết mới nhất
Đăng ký để nhận thông báo khi có bài viết mới. Không spam, chỉ kiến thức chất lượng.